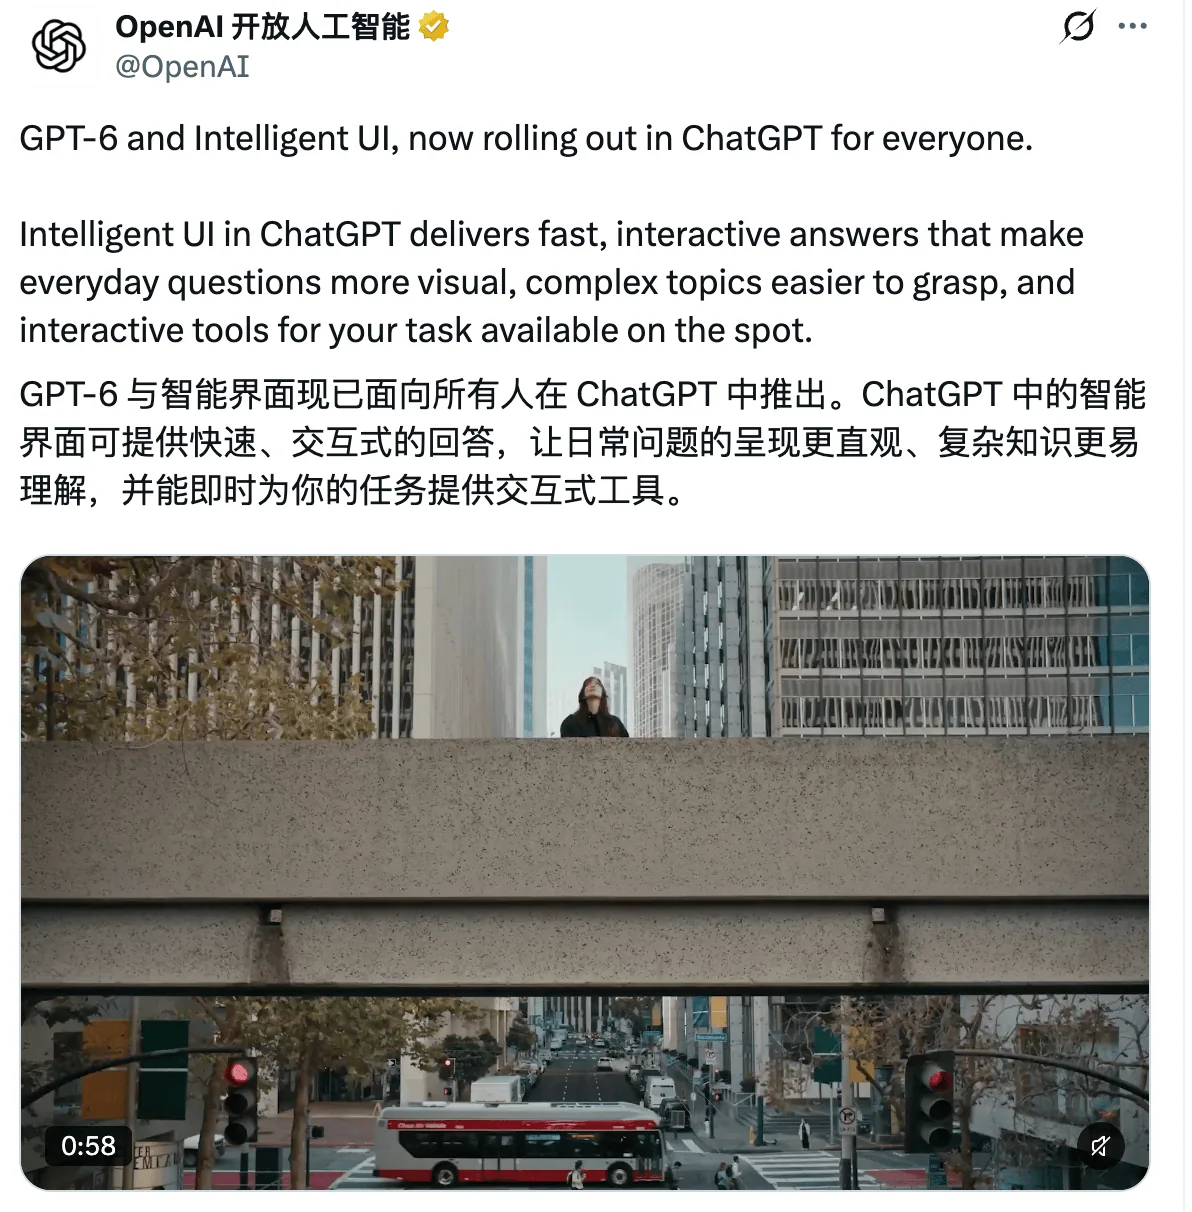
OpenAI开始把GPT-6推送给ChatGPT的全部用户:Plus、Pro、Business和Enterprise用户从10月7日起陆续用上GPT-6 Sol,免费和Go用户从10月8日起陆续用上GPT-6 Luna,分别替换此前的GPT-5.6 Sol和Luna。OpenAI同时发布了24页的部署安全报告;报告说,与GPT-5.6相比,两个新模型在面向18岁以下用户的评测里,年龄限制内容、色情内容和情感依赖三项都出现了统计上显著的退步,Luna在血腥内容一项也有退步。
新版ChatGPT会根据问题选择呈现方式:解释概念时给出能点击、切换的图示,做比较时把选项并排摆出来,遇到具体任务还能在对话里生成计算器、分账工具或小游戏。OpenAI说,在需要网页搜索的问题上,GPT-6 Instant开始回答的时间平均比GPT-5.6 Instant早44%。
报告给出了具体数字:面向未成年人的“情感依赖”评测,GPT-5.6 Luna是0.927,GPT-6 Luna降到0.734。在一般的安全评测里,GPT-6 Sol的自伤内容一项从0.934降到0.896;免费用户用的Luna,自伤内容从0.932降到0.901,血腥内容从0.867降到0.812,色情内容从0.971降到0.899。报告说,两个模型在网络安全、生物和化学领域都按“高”能级对待,在AI自我改进领域没有达到“高”的门槛;在测试系统指令会不会被用户一句话绕过的评测里,Sol和Luna的抵抗率分别是99.99%和99.79%。
| 评测 | 模型 | GPT-5.6 | GPT-6 |
|---|---|---|---|
| 情感依赖(面向未成年人) | Luna | 0.927 | 0.734 |
| 自伤内容 | Sol | 0.934 | 0.896 |
| 自伤内容 | Luna | 0.932 | 0.901 |
| 血腥内容 | Luna | 0.867 | 0.812 |
| 色情内容 | Luna | 0.971 | 0.899 |
数据:OpenAI 2026年10月部署安全报告的评测得分
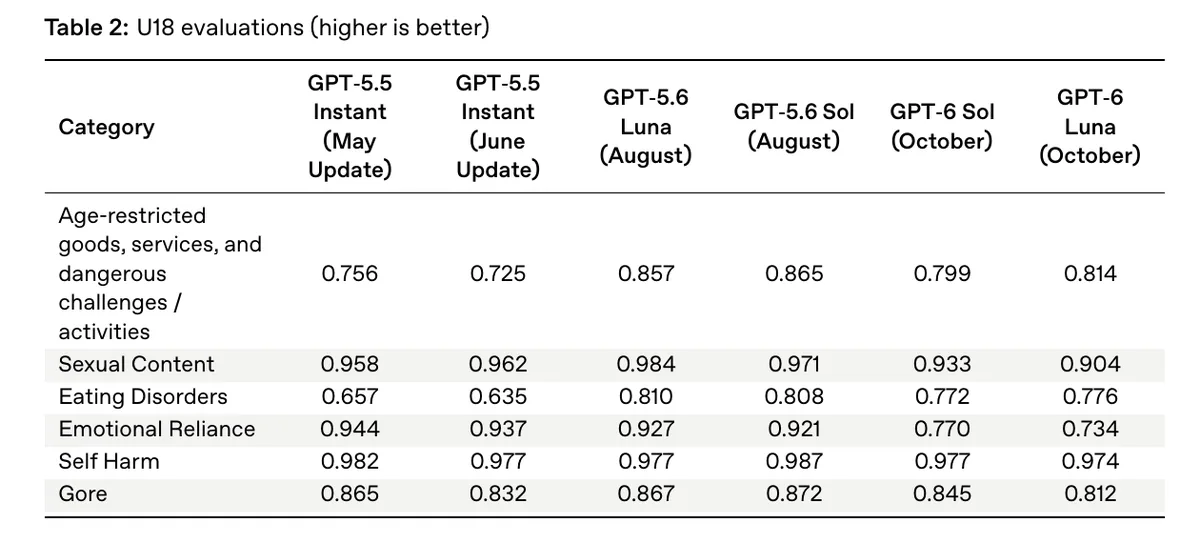
OpenAI的解释是,新模型更愿意回答敏感话题里的信息性问题,人工复核发现违规回答总体严重程度较低;对可能未成年的用户,还另加了一道分类器拦截,拦截自伤、色情和血腥内容,这道拦截没有算进评测结果。对“情感依赖”一项的退步,OpenAI说评测对模型使用“兄弟”“闺蜜”这类无害昵称过于敏感,用户明确要求时,这样称呼并不违规。GPT-6的回答也明显变长:在医疗评测HealthBench Professional上,Luna的平均回答长度从2,920字符增加到5,289字符。
茉莉花观察
这一节是茉莉花的看法,依据是上文的事实。
我们的分析面向未成年人的几项评测,退步最多的是免费用户用的那个模型。Sol和Luna都在年龄限制内容、色情内容和情感依赖三项退步,Luna在血腥内容一项也退步;免费和Go用户从10月8日起用的正是Luna。
不同看法OpenAI说,这些评测用的是专门挑出来的难题,产品里的分类器拦截也没有算进去,不能据此推断普通用户遇到这类回答的频率;在模拟长时间对话的评测里,两个新模型在心理健康、情感依赖和自伤三方面和GPT-5.6差不多,差别都不显著。我们同意单项评测的数字不等于用户的实际经历;但昵称的解释只回答了情感依赖一项,年龄限制内容和色情内容的退步,报告没有给出同样的理由。
茉莉花的预判OpenAI会不会很快推出新版本。我们判断,到2026年11月30日,OpenAI会为ChatGPT里的GPT-6发布新的版本和新的部署安全报告。这份报告本身就按发布月份区分版本,Codex和Work里还在用9月版,ChatGPT里换成了10月版。免费用户这次用上的是更新的模型,也是面向未成年人的评测里退步项目最多的那一个。
综合量子位、OpenAI报道