出品|虎嗅科技组
作者|黄天媛
编辑|苗正卿
头图|视觉中国
今日凌晨,灰测了半个月的GPT-6.2终于正式发布。
这次OpenAI带来的是GPT-6.2 Astra和Sol,一个旗舰,一个日常主力。
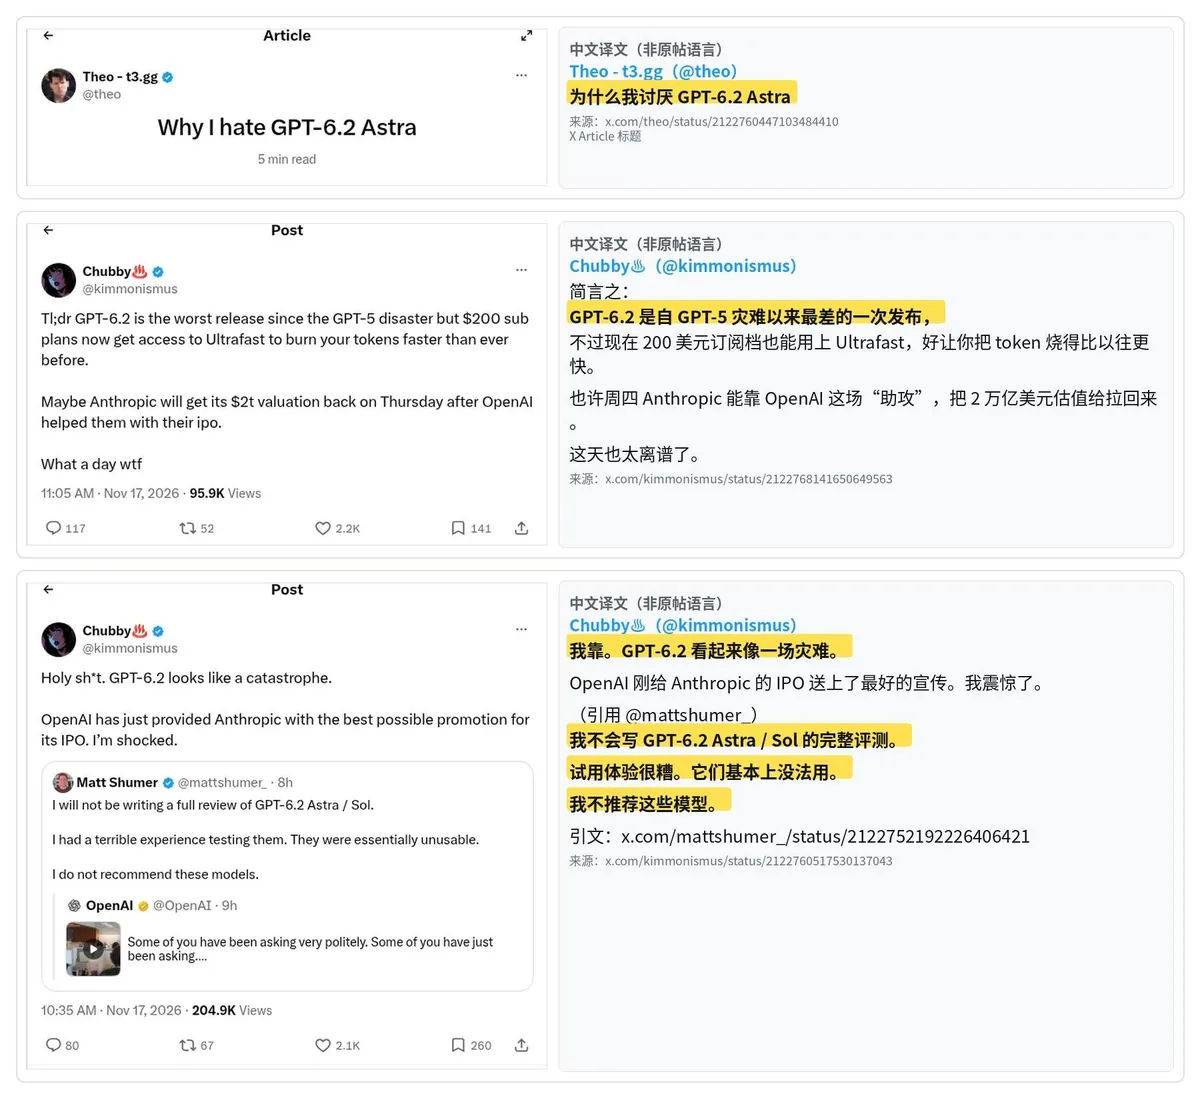
顶着Anthropic、Google压力端上桌的新模型,刚一发布,就在X上被骂成了筛子,超多人批评6.2干活不好用。
开发者Theo甚至写了个长文解释自己为什么讨厌GPT-6.2 Astra。总结一下他的观点:
-
阅读性真的很差。 Astra和人沟通的解释过于复杂,一大段字,而且常常让人看不懂,有很多防御性文案和莫名的口语表达。
-
长任务能力不行。干半天也不知道跑完了没,也不知道有没有成果。
-
遇到问题,不会自己解决,反而把问倒用户。Theo 让模型为《星际拓荒》做一个新关卡。跑了约两小时后,模型停下来,问他某个内部流程到底把视频存进了哪个文件。(?!)
一段时间过去,也有人进一步测评了6.2的其他功能。如官方所说,PPT确实做得不错,审美也有所提高,3D效果进步不少;Computer Use的效果真的很出色;后端的执行力也很不错的,足够严谨,非常适合用来执行严密工作;单次Token也确实便宜了。
简而言之,这是一个神一会儿、鬼一会儿的模型。
看看跑分
简单先总结一下这一轮6.2更新的官方说法。
-
办公能力更强。 按 OpenAI 的说法,新模型做 PPT、表格和文档时,更能照着用户给的模板来,也更符合财务、法律、销售等行业的习惯。
-
写代码和做设计有提升。 官方称它写的代码更清晰,做出来的网页更好看、更好用,还展示了根据零件图做 3D 建模的效果。(目前我实测下来审美确实比之前要好,有很多审美上的小巧思,但仍然比不上Claude)
-
科研是 Astra 的卖点之一。 它在科研评测中刷新了成绩,OpenAI 称它是目前最适合科学家的模型。
-
旗舰降价,但日常款不变。 相比上一代 GPT-6 Astra,6.2 Astra 的 API 输入、输出单价都降了 20%,缓存输入单价降了 60%。Sol 延续上一代定价。
-
做单任务成本也更低。 在官方引用的一项多步骤专业任务评测里,Astra 的单任务成本不到上一代的 三分之一。OpenAI 也称,使用 Sol 时,同样的付费套餐额度能完成更多任务。
再展开看看跑分。
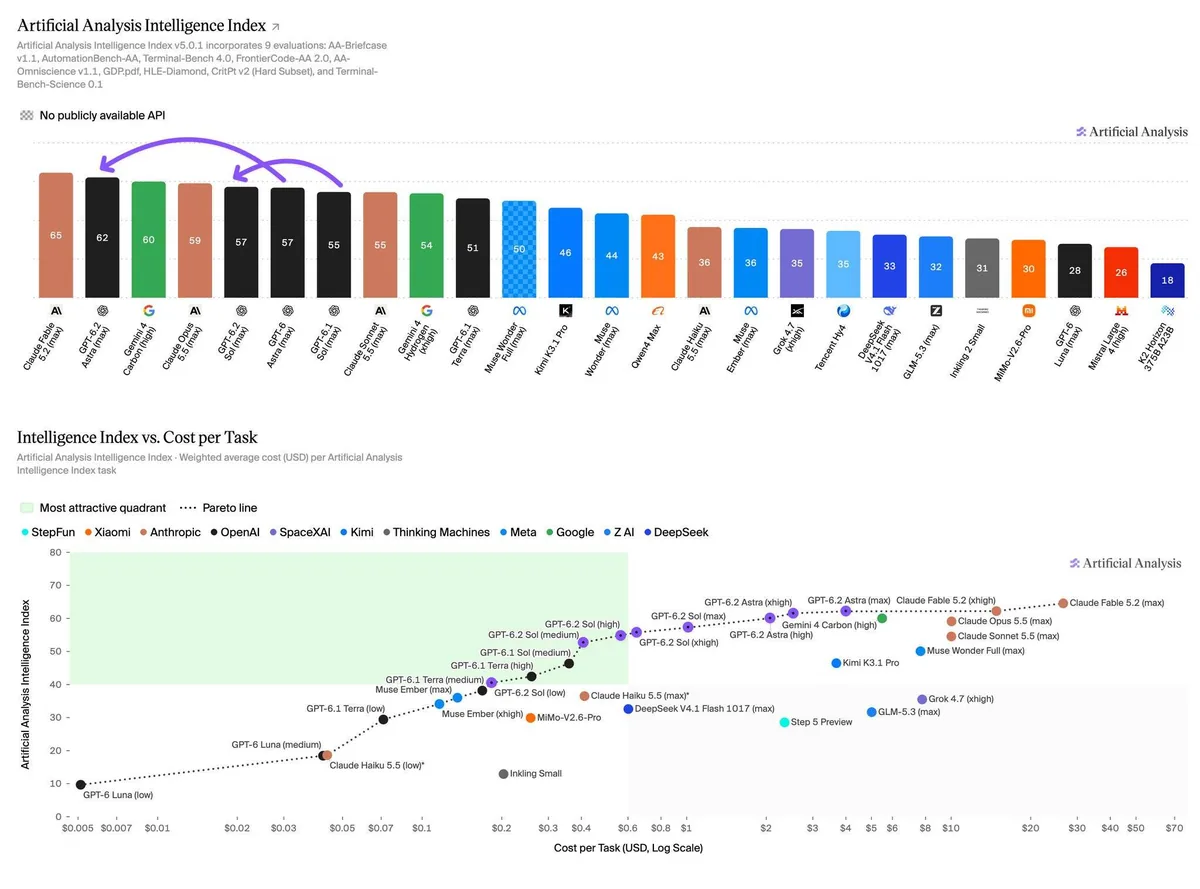
在第三方机构Artificial Analysis的综合智能指数中,Astra拿到62分,排名第二,仅次于Claude Fable 5.2的65分,超过Gemini 4 Carbon的60分和Claude Opus 5.5的59分。Sol则拿到57分,追平上一代旗舰GPT-6 Astra,但按该机构评测,单任务成本只有后者的约15%。
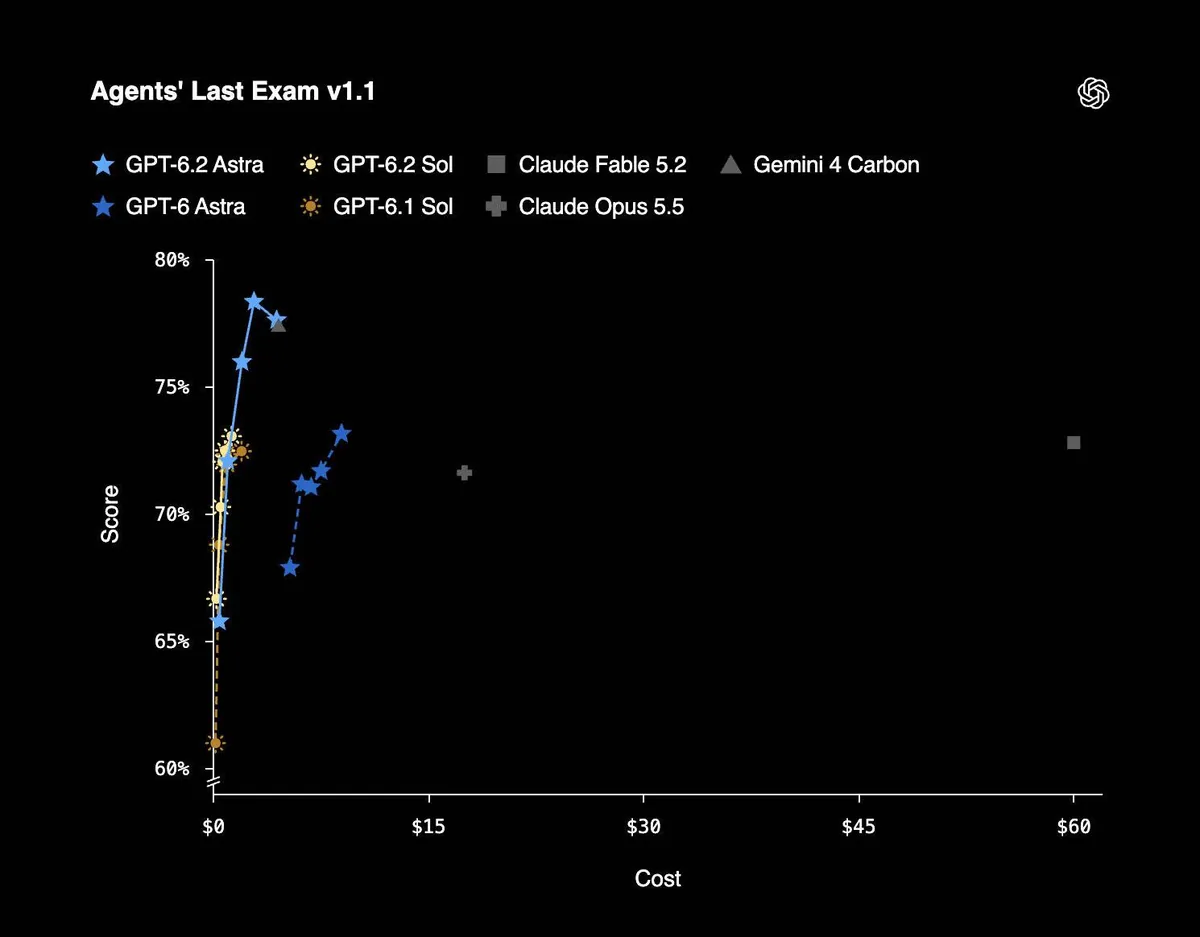
专业工作方面,官方称,在考察多步骤任务的Agents’ Last Exam中,Astra比前代提高5.2分,单任务成本不到三分之一。
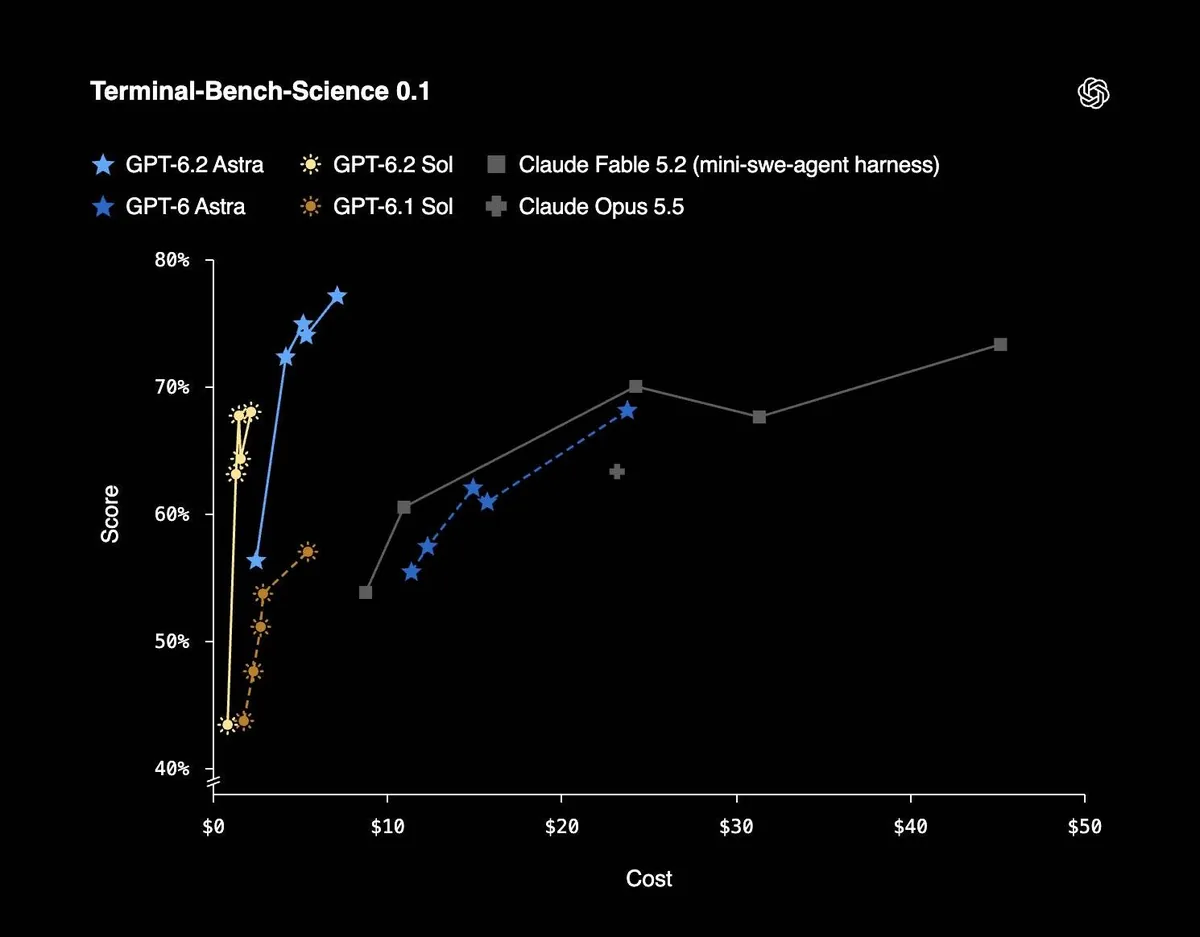
在覆盖咨询、金融和设计的内部GDPval v2测试中,Astra提高6.2个百分点,输出token减少22%。科研也有进步:在考察终端科研工作流的Terminal-Bench-Science中,成绩提高了9个百分点。
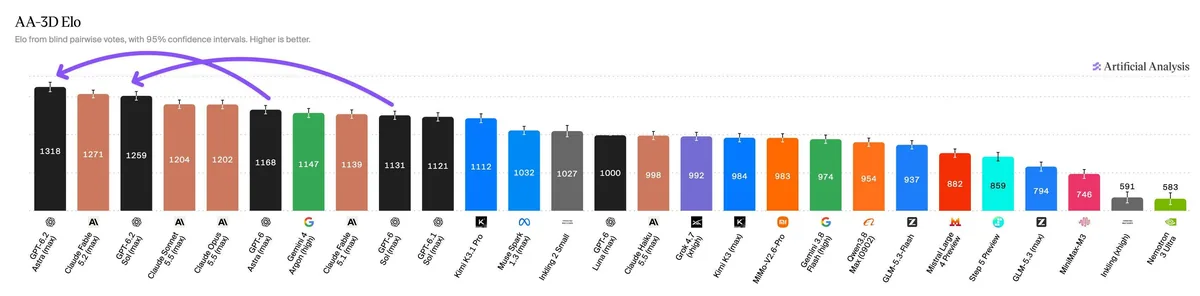
3D是另一项长板。在Artificial Analysis的人类盲测中,Astra以1318 Elo分排名第一,高于Fable 5.2的1271分。
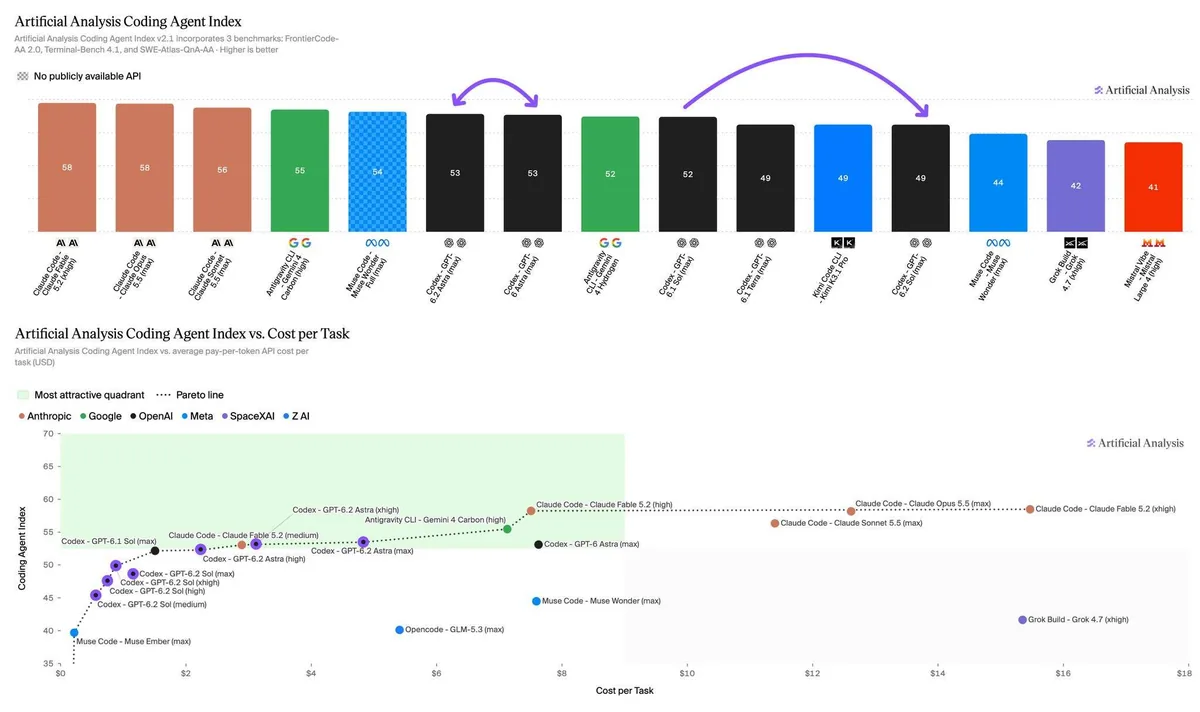
编程则没有全面跟上。同一机构的编程智能体指数中,Astra仍是53分,与前代持平;Sol降到49分,比6.1 Sol低3分。
看看实测
榜单有进步,再来看看实测。
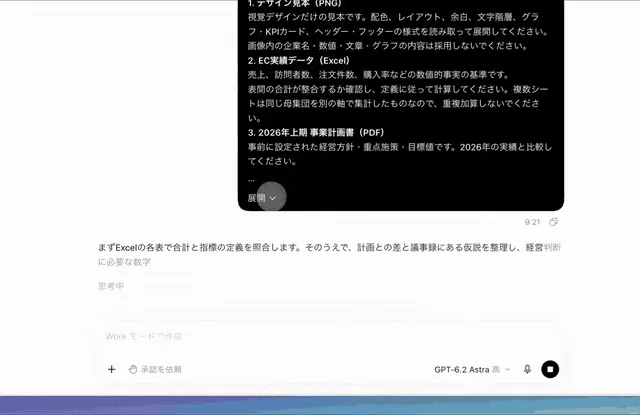
如官方所说,他们做的PPT确实不错,自己调研、找图、排版,比较适合上班族。但博主Andrew McGehee测试下来后,Sol的低推理档反而优于Ultra。
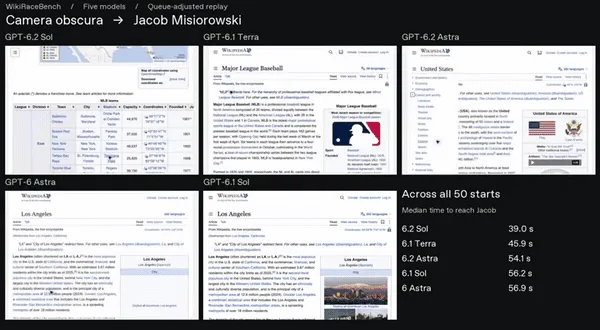
网页操作(Computer Use)也不错。博主Nick发布的维基百科跳转演示里,模型会自己点击链接、切换页面,Sol率先完成画面中的任务。他还测试了GeoGuessr,让模型观察街景、操作地图、判断位置。
一部分3D动效也有进步,镜头的运动和衔接,是有镜头语言表达的。但同一轮测试里,穿模、人物比例失衡、机械零件对不齐等问题仍然存在。
编程上的吐槽,则集中在6.2的持续性比较差。开发者们抱怨它在长任务中会抛出用户难以回答的实现细节问题,然后卡住等回复,解释又难懂,还得再找别的模型帮忙总结。并且,Astra在真实编程任务里会过早停下,非常不智能。
GPT-6.2就是一个手动挡模型。你说多少话,他干多少事。你要是想偷懒,或者还完全不知道自己想怎么操作,那6.2就要敷衍你了。或者你自己去聊一个skill出来,才能长时间跑一个东西。
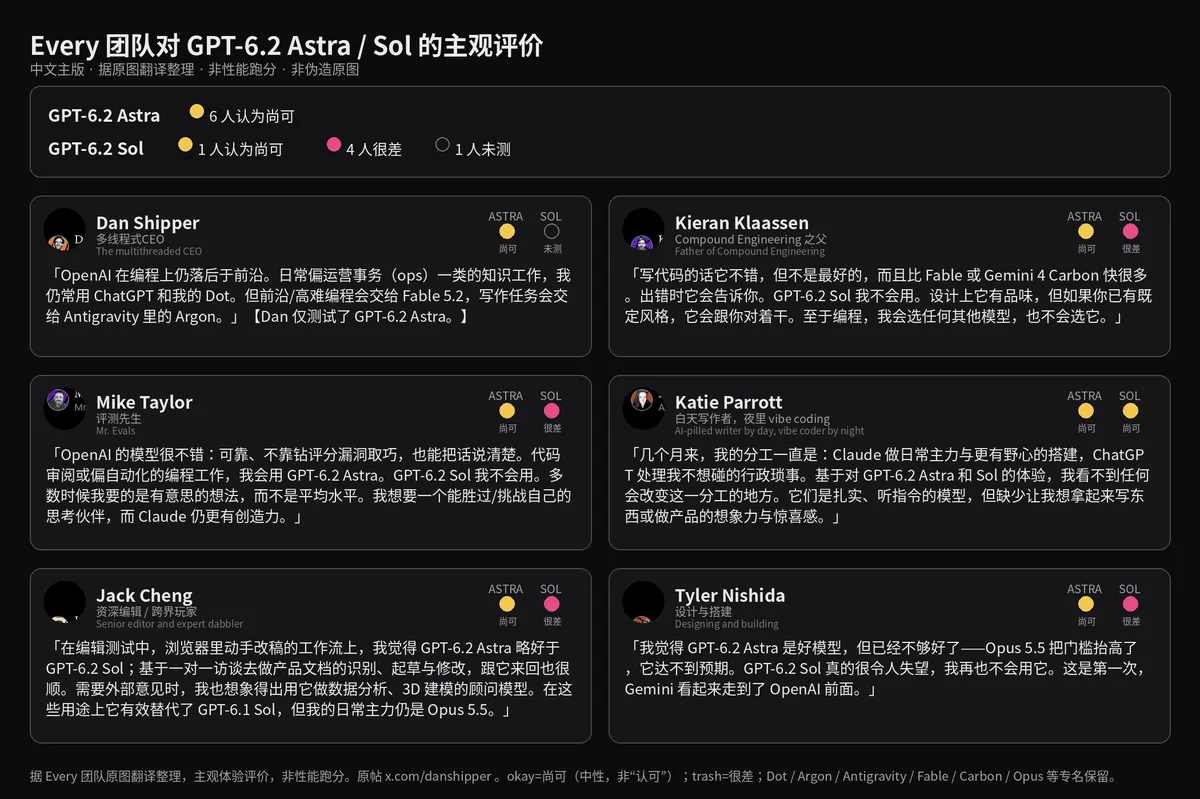
所以如果可以的话,试着让Claude做前端,GPT做后端,放在同一个工作区,不用自己手动传话,产出的结果应该会好很多。
OpenAI现在的产品适人性还是比较一般,毕竟人类最稀缺的就是注意力,这给你拉磨拉一半,换谁家牛吗都不舒服。但你也不得不承认,不封号还重置的模型,貌似就赢了一半。