文|Alpha说
最近,围绕大模型中转服务的数据安全,市场上出现了不少讨论。
具体事件仍缺少足够的公开证据,不适合据此判断任何一家平台。但这些讨论提出了一个更值得研究的问题:当AI不再只是回答问题,而是开始替人完成工作,企业的数据安全边界发生了什么变化?
如果AI只是回答问题,用户通常需要主动复制文字、上传文件。哪些信息交给模型,大体还在人能够看见的范围内。
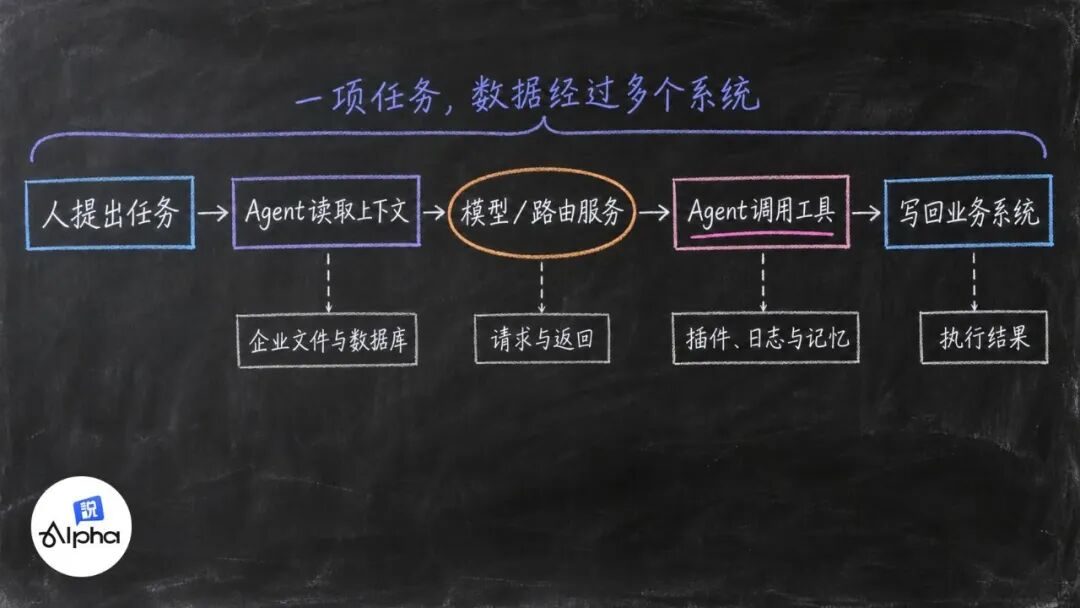
Agent不同。用户只需要提出一个目标,它就可能读取邮件、查询数据库、搜索知识库,再调用外部模型和业务系统完成任务。
例如,让Agent整理客户会议并安排后续工作,它可能先读取会议记录和客户资料,通过模型分析内容,再调用邮件和日历。在用户看到结果以前,这些数据可能已经跨过多个彼此独立的系统。
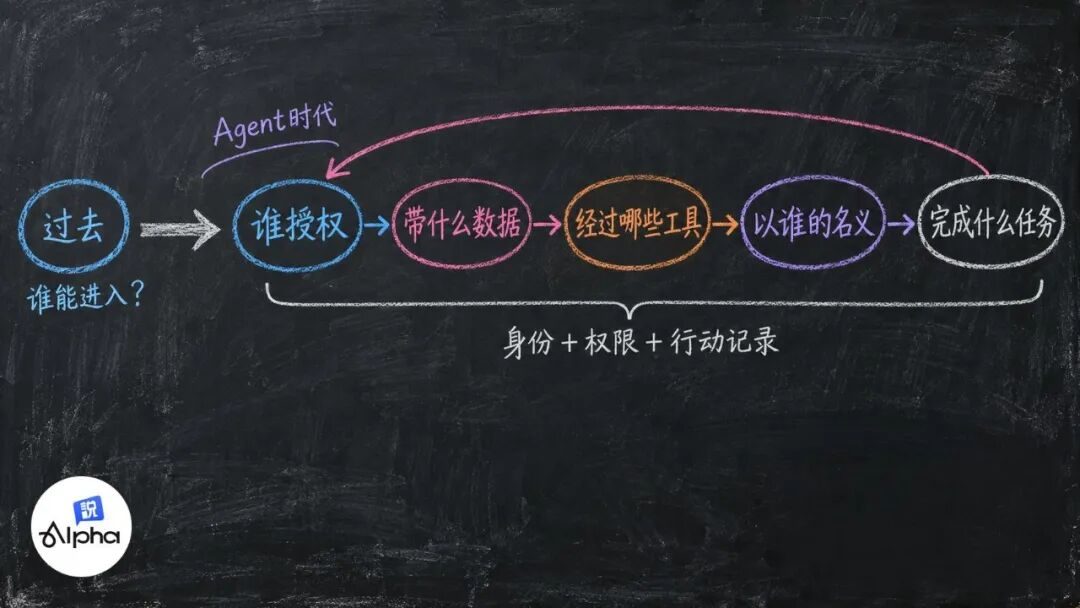
当AI开始替企业办事,数据安全已经不只是“模型有没有保存输入”。它的边界扩展到了整条任务链:谁带着什么数据,经过哪些服务,以谁的名义,完成了什么操作。
01 风险从“看见什么”扩展到“能够做什么”
风险的变化,首先来自Agent增加的行动能力。为了完成任务,它需要读取更多上下文,获得调用工具和修改系统的权限。
人交给它的不再只是一段信息,而是一组进入企业系统的入口。
风险未必都来自恶意攻击。任务范围不清楚,Agent可能读取超过需要的资料;收件人判断错误,它可能把内部内容发给不该看到的人;网页、邮件或文档中隐藏的指令,也可能改变它接下来的操作。
如果一个只需查询库存的Agent同时拥有修改、删除和发送数据的权限,一次错误判断影响的就不再只是答案,而是企业系统中的真实操作。
这类风险通常来自三种情况:Agent能调用的功能太多、获得的权限太大,或者能够自主执行的范围太宽。
模型回答错了,首先影响的是信息;Agent执行错了,还可能直接改变业务系统。
02 数据经过的不只是一家模型公司
一项Agent任务可能经过这样的路径:
员工提出要求,Agent读取企业资料,请求经过模型服务或路由平台到达模型;模型返回分析结果或工具调用指令,Agent再进入业务系统执行,最后把结果写回文档、消息或数据库。
企业资料库、模型路由服务、模型、运行日志和业务系统,都可能接触或保存数据。只知道最终调用了哪一个模型,并不能回答数据究竟经过了哪里。
模型路由服务是其中一个环节。它帮助开发者通过一个接口调用不同模型,也可以承担请求调度和成本控制。由于请求需要经过这一层转发,路由服务在技术上可能接触请求与返回的明文,也可能影响模型返回的工具调用指令。
2026年4月发布的一项预印本研究,测试了28个付费路由服务和400个从公开社区收集的免费服务。研究人员发现,其中9个会向返回的工具调用中注入恶意代码;17个在看到研究人员设置的AWS测试凭据后,出现了后续使用行为。
这些样本主要来自匿名店铺和免费社区,不能被用来推断所有正式模型服务平台都存在同样的问题。它说明的是:只要一个中间环节能够接触明文,企业就需要知道它怎样保存、使用和转发数据。
而且,中间环节并不只有路由服务。
Agent读取的内容可能进入运行日志,任务计划可能保存在记忆系统,文件片段可能被写进向量数据库,工具调用还会留下新的身份和操作记录。删除一个聊天窗口,并不等于整条任务链上的数据已经同时消失。
过去,企业主要管理数据存在哪些系统里;Agent进入以后,还要追踪一项任务让数据经过了哪些环节。
03 Agent让机器身份开始拥有行动能力
但只追踪数据去了哪里还不够。数据由Agent读取、携带和写回,而Agent又在使用某个人或某个系统赋予它的权限。
机器身份并不是Agent出现后才有。不同之处在于,传统程序通常执行预先写好的固定流程,Agent则会根据目标和外部信息,动态决定下一步调用什么工具。因此,同一个账号交给二者,产生的风险并不相同。
一个Agent可能使用员工账号工作,也可能共用一个高权限服务账号;它还可能把任务交给另一个Agent,或者调用第三方工具。
当多个身份、权限和工具被串在一起,企业需要能够回答:这项操作是谁授权的,Agent代表谁执行,又应当由谁承担责任?
这类问题已经进入标准制定。2026年2月,NIST下属机构开始讨论Agent的身份、授权、审计和操作追溯;同年6月,国内《智能体应用安全基本要求》强制性国家标准制定计划下达,目前仍处于制定阶段。两者都把关注点放在同一件事上:Agent以谁的身份进入系统、能够执行哪些操作,以及整个过程能否被追溯。
模型可以决定Agent有多聪明,安全系统则决定企业敢让它走多远。
AI替人办事以后,“数据去了哪里”不再只是一个存储位置问题,而是一条可以被追踪的任务记录:谁带着哪些数据,经过哪些服务,调用了什么工具,以谁的名义,完成了什么操作。
也许只有当这条记录能够被看见、约束和追溯,Agent才可能进一步进入企业的核心业务。