Jev火了。
AI圈每隔一段时间就要上新。这是继Token、龙虾、世界模型之后,在最近半个月,和RSI(递归自动改进)并列齐驱的时新名词。
中文互联网很快把Jev概括成了“只会做选择的新模型”。
Jev不聊天,也不写文章。开发者给它材料,再列出问题和候选答案,它只负责做判断:选哪个、打多少分,以及判断把握有多大。
比如收到一封客服邮件,它可以判断应该分给退款组还是物流组,也可以判断是否需要转人工,或者由交给LLM完成。
TypeSafe官网把两个数字放在了最显眼的位置:“比LLM快193.6倍,便宜444.6倍的新模型。”
社交媒体上,有人因此兴奋地说,Jev开辟了一条LLM之外的新路线:不追求所谓powerful,而是把模型变得更简洁、克制、直接。
但另一边,也有人不买账,“不过是NLP时代玩剩下的东西。”
创始人与他想解决的事
首先,我们来介绍一下Jev之父,创始人Diogo Almeida。
Jev由旧金山公司TypeSafe AI推出。创始人Diogo Almeida先后在Google Brain和OpenAI做研究,是InstructGPT论文和GPT-4技术报告的署名作者。
Jev的推出,是Almeida早期未完成的心愿。
Almeida在近期的采访中回忆,InstructGPT早期准备上线时,他曾极力推动这件事。因为清理PPO训练数据太慢,他还自己写过一套没有公开的算法,希望尽快把模型交到用户手里。
模型很快流行起来,但他发现这些模型的主要应用是批量生成广告文案和网页内容。
他感到失望,也开始反思、追问:这么聪明的模型,为什么仍然接不了那些普通、重复又枯燥的工作。
他认为,真正实现自动化,大多数时候应该由代码自己调用AI,人类不会也不应一直守在聊天框前。
这个念头在ChatGPT发布前就已经出现,他一度拿去和Sam Altman讨论,后来才离开OpenAI创办TypeSafe。
公司刚起步时,几名成员直接搬进他的公寓一起赶研究,这还让洁癖的Almeida难受了好久。
团队两周内拿到第一笔投资,但产品磨了两年才正式发布。
9月15日,TypeSafe正式推出Jev,同时宣布由DCVC领投的4000万美元种子轮融资。
这里,我们也总结了创始人近期在X和播客上的发言,你能从中窥见他的产品与技术偏好。
-
聊天能力没有自然带来自动化。 模型已经很会说话,却仍需要人给目标、检查结果并承担错误。ChatGPT与Claude Code依然属于辅助工具。
-
RLHF优化的是人的偏好。 人类更容易奖励流畅、自信、看起来有帮助的回答。这让模型更好用,也可能让它在没有把握时表现得过于肯定。
-
自动化需要可靠的不确定性。 软件除了要知道模型选了什么,还要知道这个选择有多可信。置信度足够可靠,程序才能决定自动执行、再次检查或交给人。
-
Jev主动放弃自由文本。 它不写文章和代码,只在开发者给出的选项中做选择、打分或返回概率。能力范围变窄,换来了更简单的输出和更低的计算量。
-
Jev想把判断直接交给代码。 LLM经常先生成一段解释,程序再从中提取标签。Jev直接返回规定好的类型和概率,结果可以进入条件判断和工作流。
-
并行计算是速度优势的主要来源。 LLM通常逐个生成token,Jev可以同时计算多个问题和候选项。TypeSafe观望据此宣称它在特定任务中快20至200倍、便宜40至400倍。
-
代码负责规则,模型处理模糊判断。 普通代码规定流程和权限,Jev负责路由、评分与风险检查,LLM继续承担规划、写作和代码生成。
-
Jev最先替代的是Agent里的小调用。 该用哪个工具、结果能否通过、任务是否结束,这些问题过去经常消耗一次LLM调用,也更符合Jev的能力范围。
-
类型安全不能保证判断正确。 Jev不会突然编出一个不存在的选项,仍然可能在合法选项中选错。它适合按置信度分流,不能因此取消业务检查。
-
Jev只是机器原生模型的第一步。 Almeida不希望它长期只被理解成分类器或决策模型。他想做的是供软件调用、能够大量组合的智能部件,用更便宜的判断推动更多自动化。
三个争议问题
社交媒体上,大家讨论最多的是Jev的宣传速度。TypeSafe自己的四套工作流测试结果显示,如果完成同一套决策流程,LLM花费的时间和钱是Jev的193.6倍和444.6倍。
但自动化服务公司AY Automate在2026年9月20日发布的第三方测试报告显示,Jev比几款对照模型快约2到3.6倍。和便宜小模型相比,它省下的费用约为4.7到7.5倍,和较贵的前沿模型相比才达到40到49倍。
第二个争议是Jev是不是一个分类器。
因为技术逻辑相近,很多人认为Jev就是个“分类器”。分类器是给东西贴标签的模型,比如把邮件分成正常邮件和垃圾邮件。
在一些程序员论坛中,不少程序员提到结构化输出、限制解码、读取候选token概率早已存在。(虎嗅注:BERT是典型的encoder模型,擅长分类、匹配和打分。GPT、Claude这类聊天模型通常是decoder-only模型,擅长写文章、代码和对话。)
因此,Jev可能更接近BERT一类encoder模型,是“新瓶装旧酒”,并没有太多技术含量。
但按照TypeSafe创始人Almeida的说法,Jev采用了一套名为RLCD的训练方法,训练目标是让模型直接作出选择、评分并给出概率。
不过TypeSafe尚未公开架构,其训练方法是否如其所说,仍无法判断。
第三个是幻觉问题。
Jev官方反复强调的另一个卖点是,不会出现幻觉。
传统 LLM 即使被要求返回 A、B、C选项中的一个,也可能输出一段解释、错误格式甚至一个不存在的选项。但Jev 的输出空间则提前被定义,它只会返回软件允许的数据类型。官方把这一点称为“type-safe”。
但不会输出错误格式,并不等于不会做出错误判断。
如果问题只有 A、B、C 三个选项,Jev 可以保证不会突然回答 D。但它仍然可能选择错误的 A,也可能对一个错误答案给出过高的置信度。
开发者 Simon Willison提醒,Jev 甚至可能比传统 LLM 更“黑盒”。因为LLM 至少还能被要求解释自己的判断,但Jev 最终留给开发者的,可能只有一个数字,比如0.83或10000。这个数字为什么是 0.83或10000、模型依据了文本中的什么特征,根本无法得到追问。
而 Jev 发布不到一周,社区已经开始尝试复刻这种形态。
例如开源项目Kev直接基于Qwen 3.5制作了 0.8B、4B 和 9B 三个 Jev-like 模型。
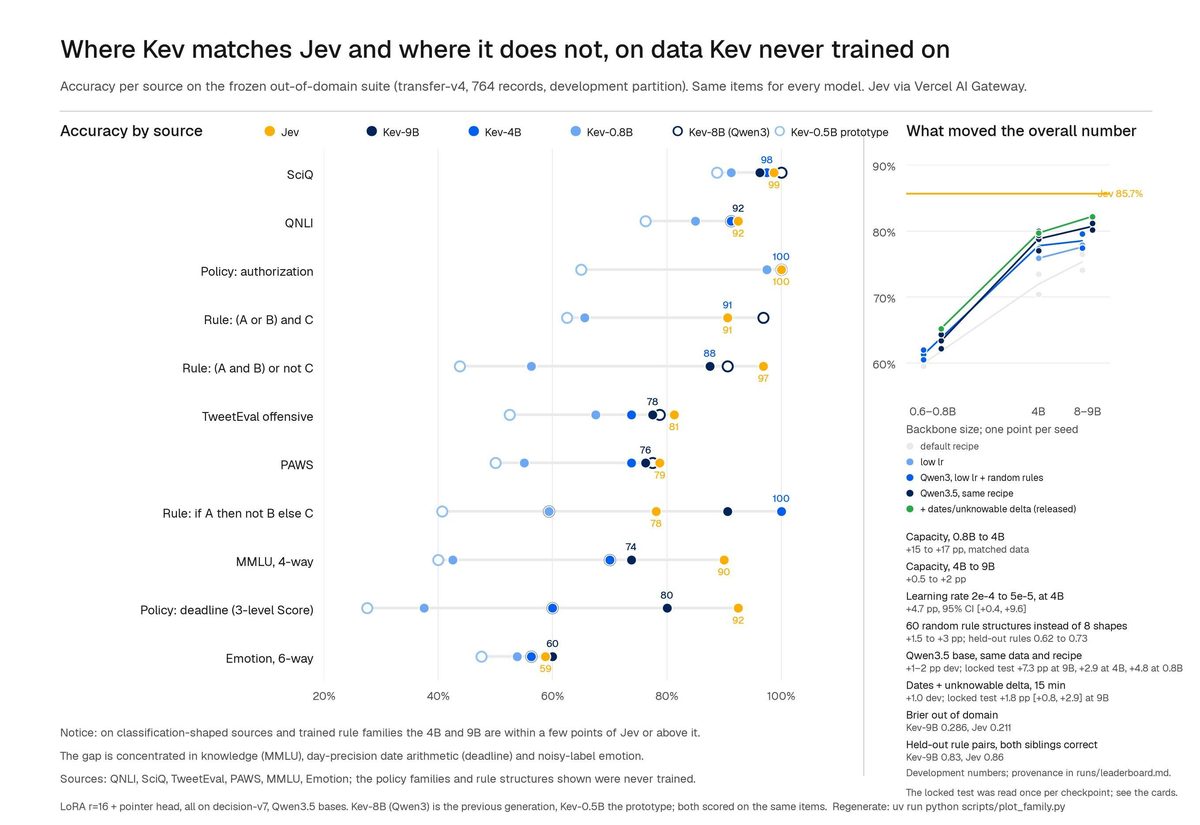
另一个 JevRL 项目则在小型语言模型之上增加决策输出模块,同样尝试实现 Choice、Score 等结构化概率输出。
因此,有更多人认为,Jev可能就是套壳。而把语言模型从“生成文字”改造成“输出判断”,并不一定只有Jev一条技术路径。
所谓Jev成为下一个LLM,更是天方夜谭。
逃不掉的商业化
云计算和前端开发平台公司Vercel给出了一些Jev的应用案例,比如表单路由、客服工单优先级、文档分类、内容审核以及搜索排序等场景。
它还建议把企业软件拆成三个部分:确定性的规则继续交给代码,Jev 负责需要语义理解的判断,真正需要生成文字时,再调用传统大模型。
但相比这些传统分类任务,Jev 更大的潜在市场可能来自 Agent,实现一些小决策。
一个 Agent 真正工作起来,需要不断做决策:下一步调用哪个工具?刚才的执行是否成功?要不要重试?应该继续执行,还是询问用户?某一步是否需要人工审批?
Vercel目前已经把Jev放进了这样的 Agent loop里,让生成模型负责理解和提出行动,Jev可以位于中间的决策节点,对下一步行动进行选择或者检查,而真正的权限和执行仍由代码控制。
按TypeSafe的定价,如果一次判断平均消耗1000个输入 token,100万次判断的模型费用只有约42美元。
上线 Vercel AI Gateway 24小时后,接近13%的付费团队已经使用过 Jev。截至9月21日,Vercel公开榜单中,Jev已经占到平台约21.2%的请求量,触达29%的团队。
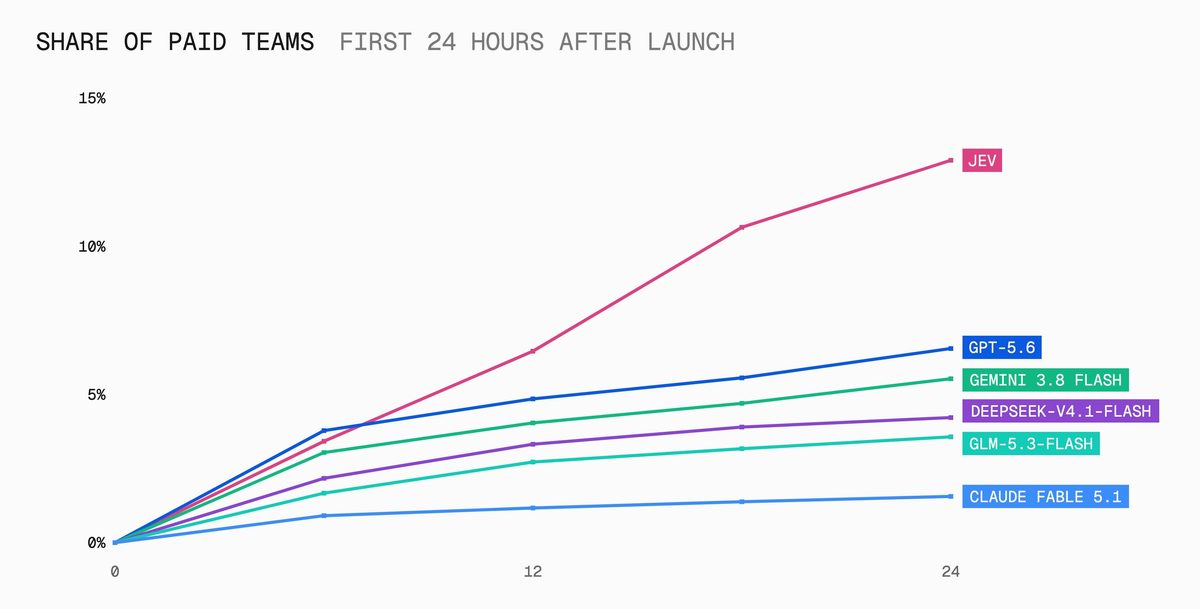
但这组数据不能直接等同于商业成功。Vercel目前正在对 Jev进行限时免费推广,9月25日优惠结束后,有多少能够在付费后留下,还需要继续观察。
同时,足够低的单价也意味着另一重压力:Jev需要极其庞大、持续的调用量,才能真正撑起可观的收入规模。
但不管怎样,Jev的爆火都像是一个信号。
过去几年,AI行业最关心的是模型还能不能更强、更大、更聪明。而现在,问题开始变成:已经足够强的模型能力,该怎样被放置进真实的场景里。
合适比最好更重要。