出品 | 虎嗅科技组
作者 | 易玉琴
编辑 | 苗正卿
头图 | AI 生成
具身数采中心,近期被推至风口浪尖。
前不久,梅卡曼德创始人邵天兰公开质疑具身智能行业里的“攒局”现象,具身数采中心被卷入其中。
这和一年前的气氛已经明显不同。
彼时,各地还在密集签约、开工,几十台、上百台机器人被搬进一个个新建的训练场。短短两年,全国已经出现了百余家集中式数采中心。
这些中心如今到底运行得怎么样?
过去一段时间,虎嗅对全国集中式具身智能数采中心进行了一轮梳理。统计截至2026年8月,共收录106个已经公开披露的项目。(虎嗅注:调研数据主要覆盖公开披露、具有固定场地和一定机器人部署规模的集中式具身智能数据采集中心、训练场及训练基地。部分项目公开信息有限,各项细分统计以可确认样本为准。)
同时,我们交流了十余家机器人本体企业、数采基地运营商、数据服务企业及地方产业人士,并将公开项目数据与一线运营情况进行交叉验证。
从这106个样本来看,数采中心的故事,已经走到了一个新的阶段。
两年建了106家,数采中心为什么突然遍地开花?
数采中心真正热起来,是从2025年开始的。
此前,这还是一个相对边缘的概念。2024年3月至2025年3月,全国平均每个月只有约2.7个项目启动。
到了2025年春天,节奏突然加快。从2025年4月到2026年1月,月均启动数量上升至约7.3个。训练场、数据采集基地、具身智能创新中心开始在各地密集落地。
建设高峰出现在2026年一季度。此后,新启动项目开始减少,前一轮开工的项目陆续投入使用。
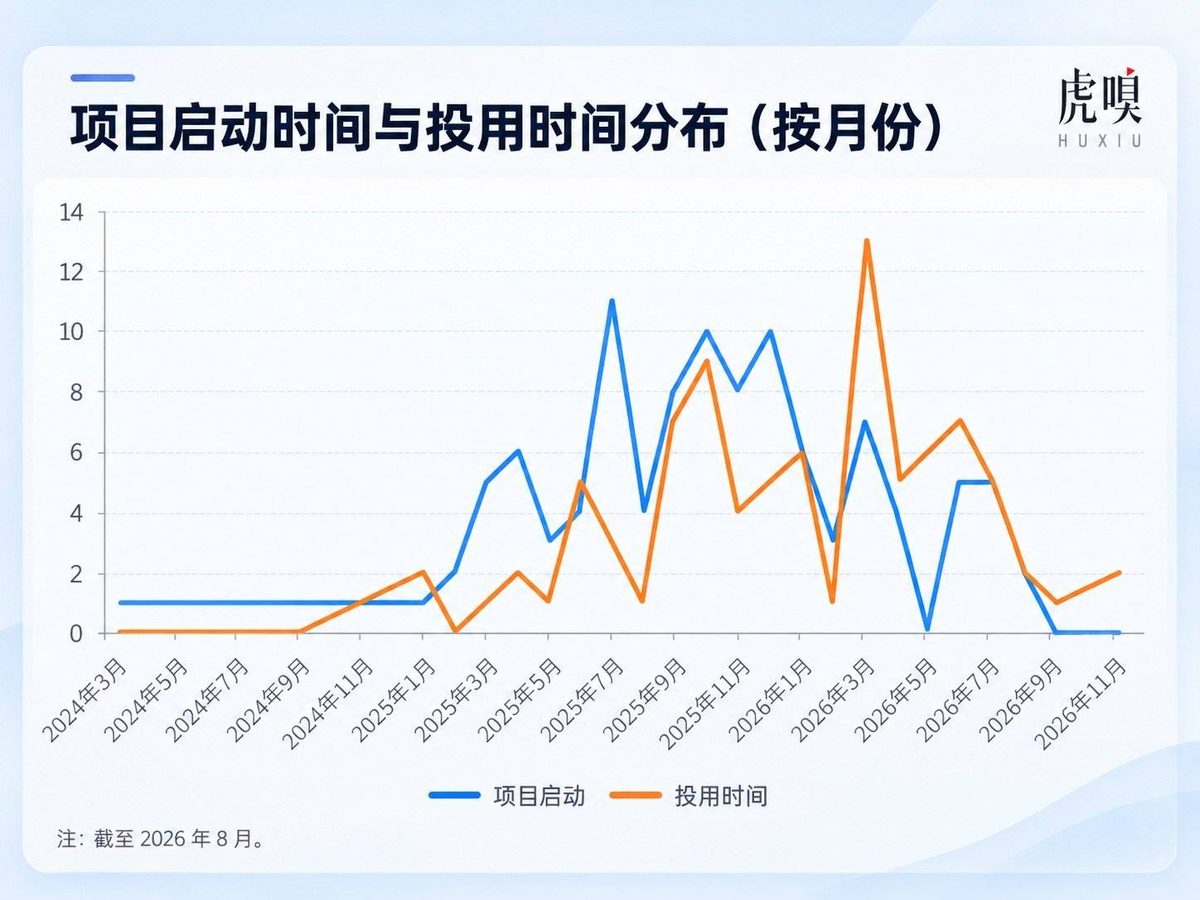
启动和投用两条曲线之间,大约隔着2到5个月,这也是一座数采中心从签约、装修、设备进场到正式运行的大致周期。
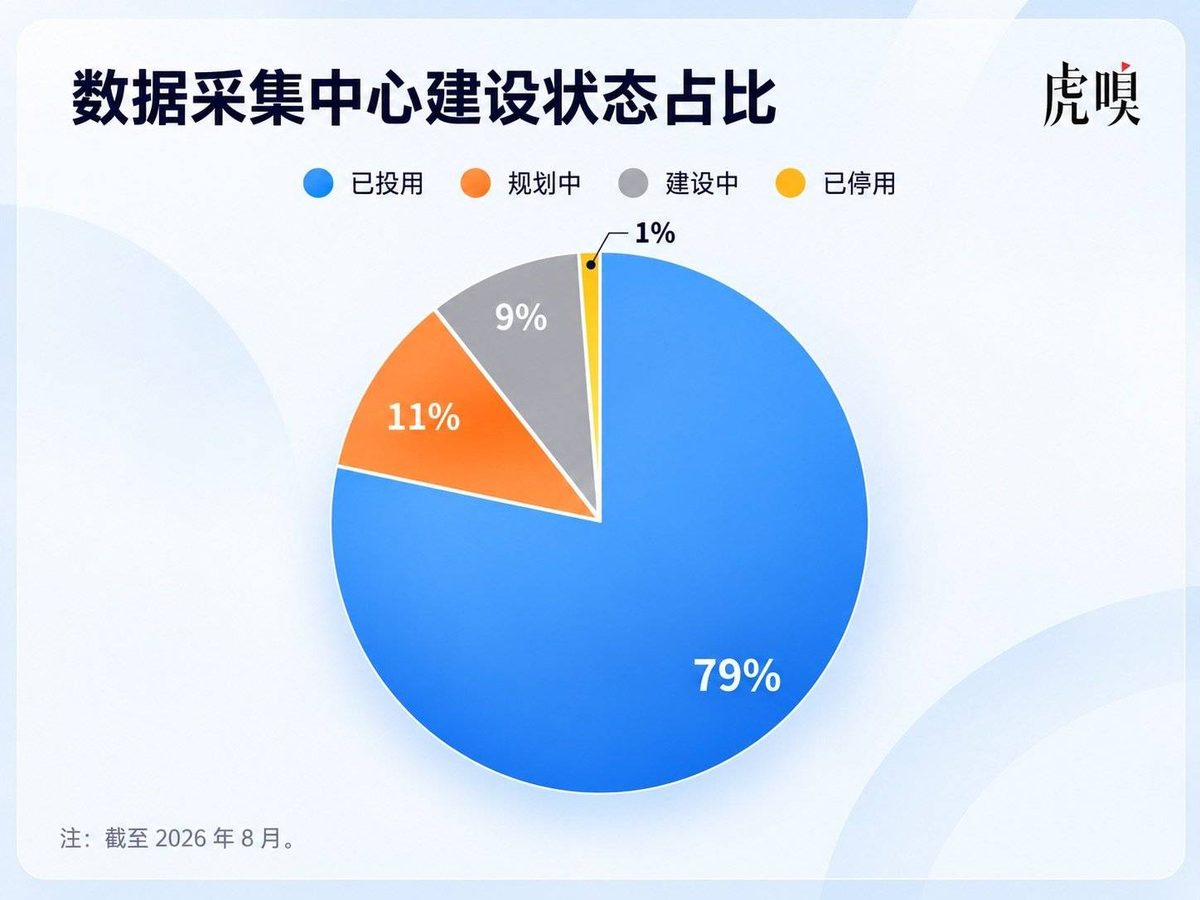
截至今年8月,虎嗅统计的106家集中式数采中心中,已经有84家投入运营,占79.25%。
这意味着,建设潮已经过去了。数采中心正在从密集开工,进入集中运营阶段。
按照实际建设方式,目前,数采中心大致又可以分为三类。
一类是机器人本体企业、数据公司自建。这类基地通常直接服务企业自己的模型训练和产品迭代,部分数据也会用于对外合作或开源。
另一类是高校、高职院校建设的训练和实训基地,兼顾科研、教学和数据采集。
数量最多的是政企共建项目。地方提供场地、资金、政策和产业资源,企业提供机器人、技术和运营团队。
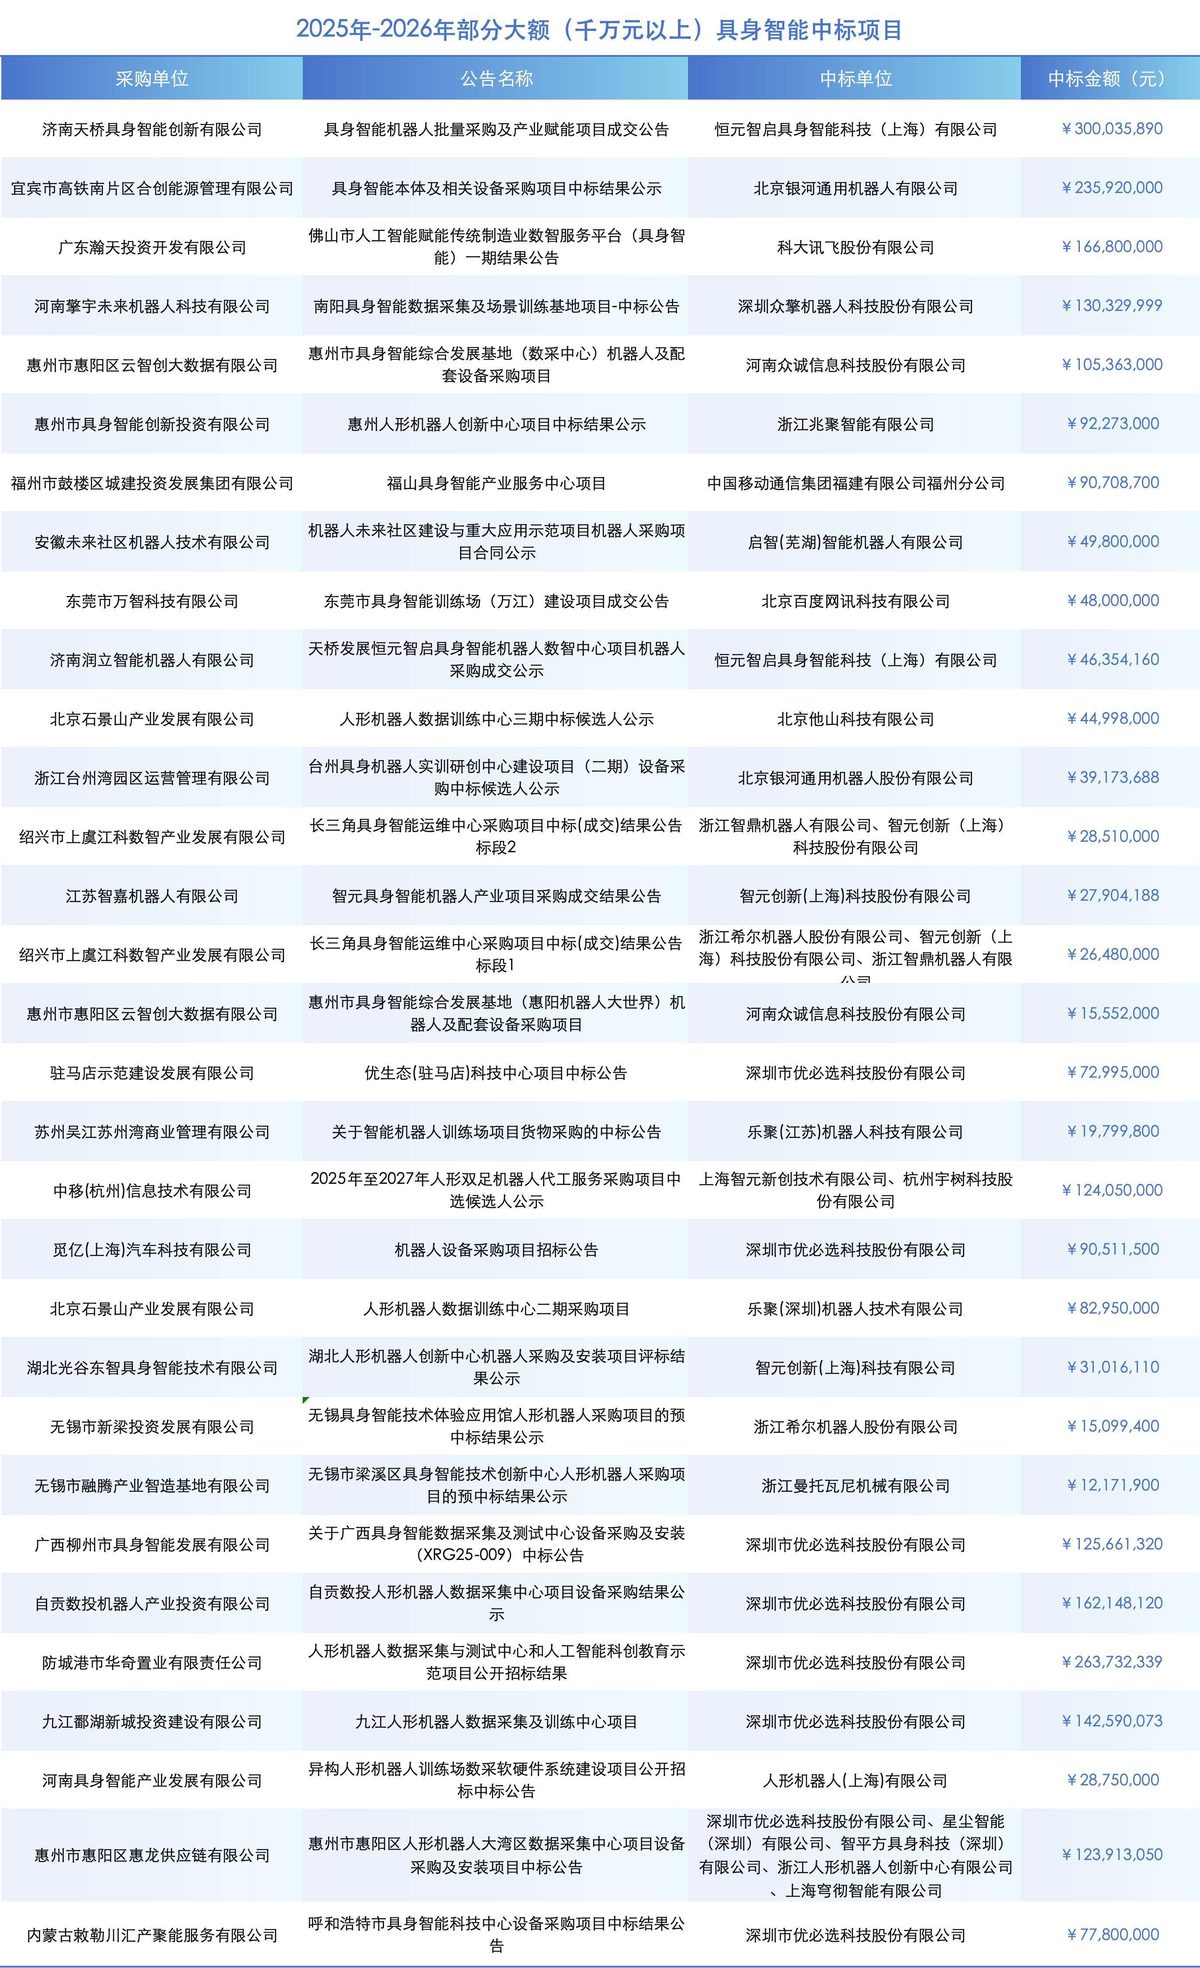
虎嗅进一步梳理了过去两年具身智能领域千万级以上的大额中标项目,发现其中相当一部分都指向政企共建型数采中心。相比单纯采购几台机器人,这类项目往往一次部署几十台甚至上百台本体,同时包含场地、数采设备、平台系统和运营服务,合同金额也因此被迅速拉高。
一位参与过多个地方具身智能项目招商的人士告诉虎嗅,数采中心最大的吸引力,是“落地快”。
“引进一个整机工厂,周期很长;引进大模型公司,人家未必愿意来。但数采中心不一样,有场地、有机器人、有工作人员,很快就能形成一个项目。”
这句话也解释了为什么一些原本机器人产业基础并不强的地区,对数采中心同样积极。
从数量上看,江苏有18家,浙江17家,广东11家,四川8家,北京7家。长三角依旧最密集,但四川、广西、江西这样的中西部地区也能迅速跟上。
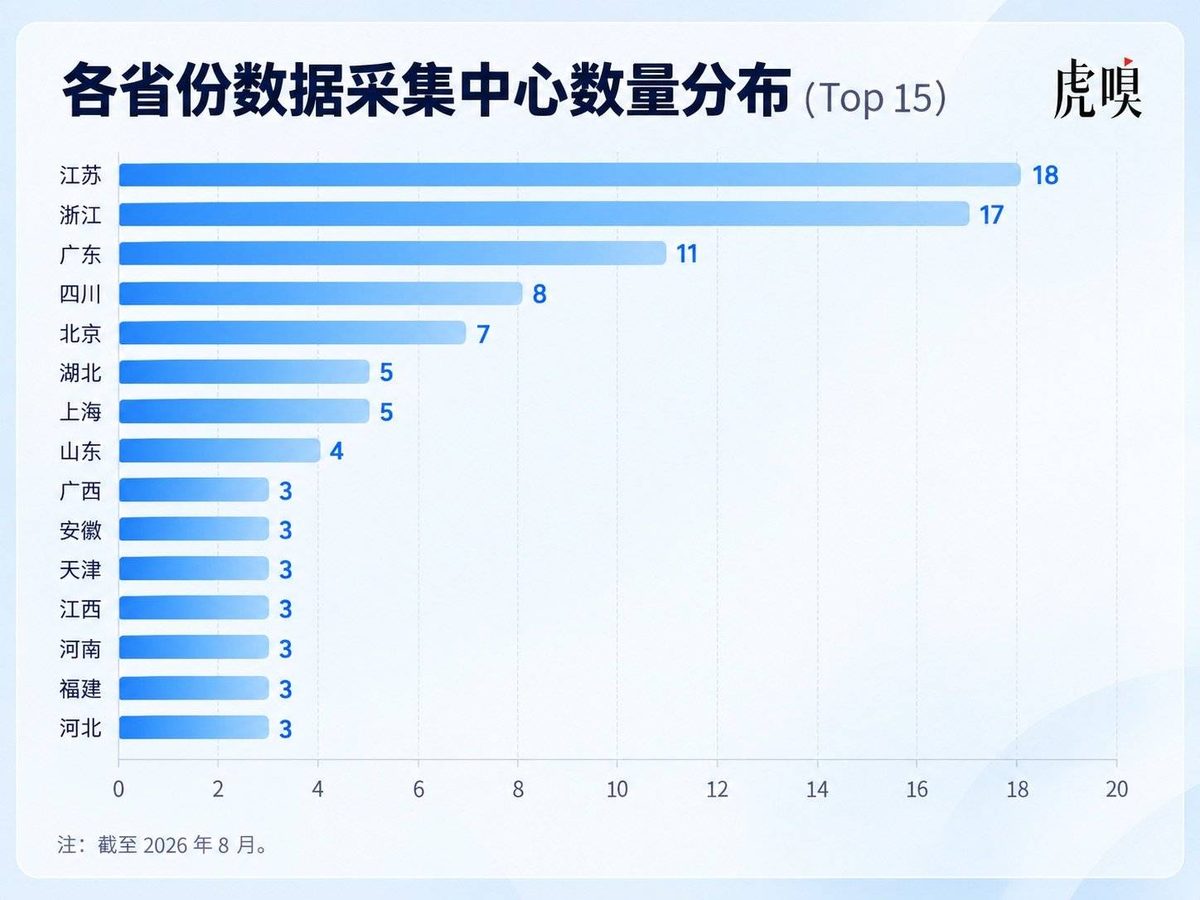
虎嗅注:上述数据统计以公开披露信息为准
地方有自己的需求,企业也有。多位机器人企业人士向虎嗅提到,数采中心已经成为部分地方招商谈判中的常见合作形式。
有的本体企业会提出,希望地方配套采购一定数量的机器人,或共同建设训练基地;也有地方主动给出数采中心、场地和订单,希望吸引企业注册公司、设立研发团队或区域总部。
对于仍处在规模化落地早期的机器人企业来说,一次几十台甚至上百台的集中采购,本身就有足够吸引力。机器人进入基地后,又能够继续生产真机数据,服务后续模型训练。
数采中心也因此成了过去两年机器人本体企业扩大装机量的一条重要渠道。
地方需要具身智能产业的落点,本体企业需要订单和场景,模型训练又需要更多真机数据。几股力量在同一时期汇合,最终推动了106家集中式数采中心快速落地。
只是到了今年下半年,这轮扩张已经明显慢了下来。
华南一家规模化数采基地的运营方告诉虎嗅,今年以来,地方政府对数采中心的资金投入已经明显有所收窄。“政府的钱不可能一直投,最后还是得找到真实的商业模式。”
第一轮建设潮已经接近尾声。
接下来,这84家已经投入运营的数采中心,需要回答的是另一个问题:每天生产出来的数据,到底值多少钱。
超5000台机器人,采出来的数据能不能用?
随着数采中心陆续投用,越来越多机器人被集中放进训练场。
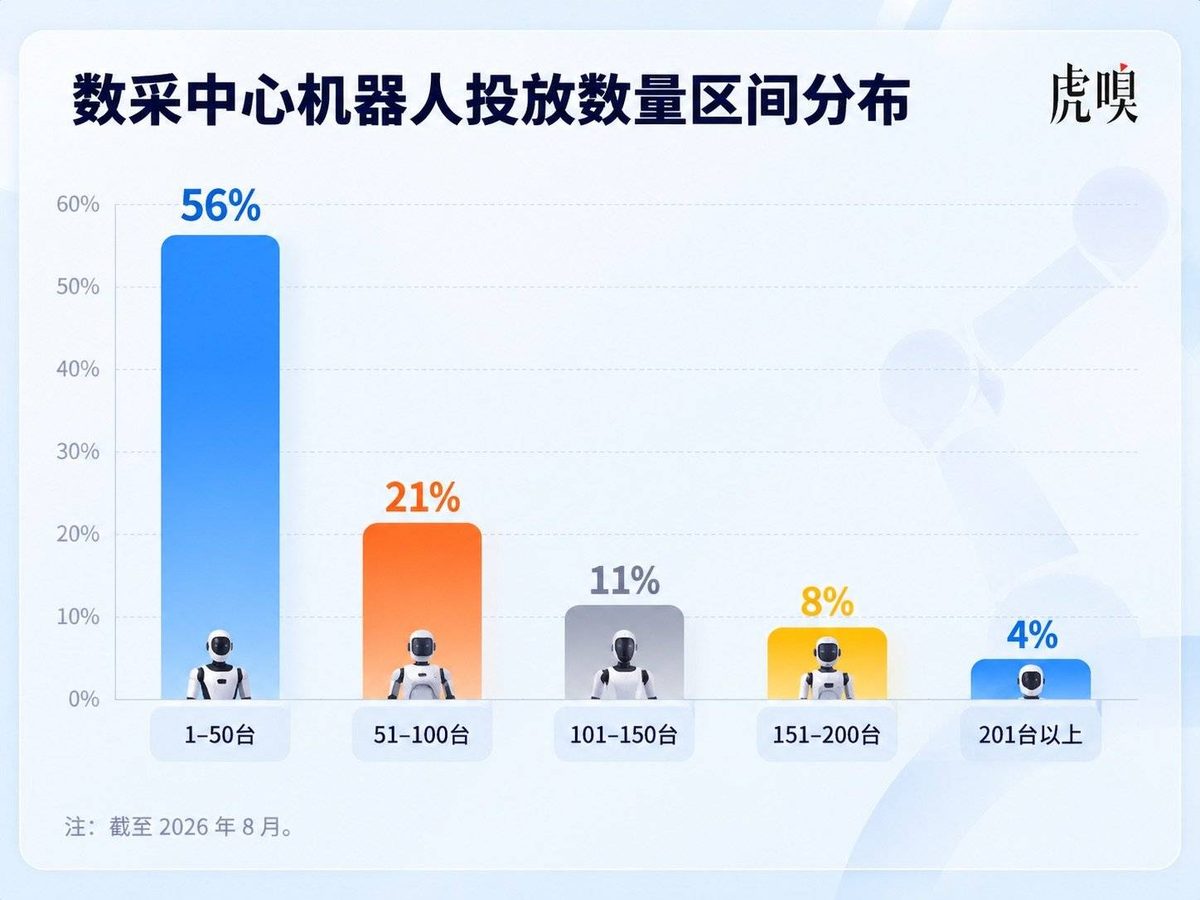
在统计的106家中心中,有52家披露了机器人部署数量,合计约3972台。单个中心投放规模从10台到300台不等。据现有样本估算,全国数采中心中运行的机器人数量至少超过5000台。
其中,超过半数(55.8%)的数采中心投放量在50台及以下,目前行业仍以中小规模基地为主。
宜宾高铁南区西南具身智能训练中心和开普云具身智能训练场均部署了300台机器人,并列第一。智元机器人临港工厂、西南基地,以及柏川数据、惠湾区等基地紧随其后,规模均在200台左右。
在数采基地里,机器人抓一个零件、放下,再抓一次;打开柜门、关上,再重新来一遍。工业装配、物流搬运、家庭整理等任务,被拆成一个个动作,反复采集。
遥操员坐在一旁持续操作,系统同步记录视觉、动作轨迹、关节状态和力反馈等数据。
一家在全国落地了十余家数采中心本体企业告诉虎嗅,具身智能行业长期面临着缺数据的问题。
“LLM(大语言模型)有海量互联网数据。但机器人需要的是,真正带动作轨迹、机器人状态和力反馈的数据,而这些数据往往需要通过真机采集来获得。”
集中式数采的价值也在这里。把设备、场景、遥操员和数据处理流程集中起来,可以更稳定地生产真机数据;对于没有能力自建数采体系的企业,也可以通过外部基地完成采集。
机器人进入数采中心之后,用途也不只有采数据。长期、高频运行本身就是一次压力测试,硬件稳定性、控制精度和任务执行中的问题,往往会在这个过程中暴露出来。
从机器人厂商的出现频次看,头部企业已经占据了更多位置。
在统计的项目中,智元机器人出现31次,乐聚15次,优必选13次,宇树科技和银河通用各10次。傅利叶、星海图、零次方等厂商出现2至6次,还有40余家企业只出现过1次。
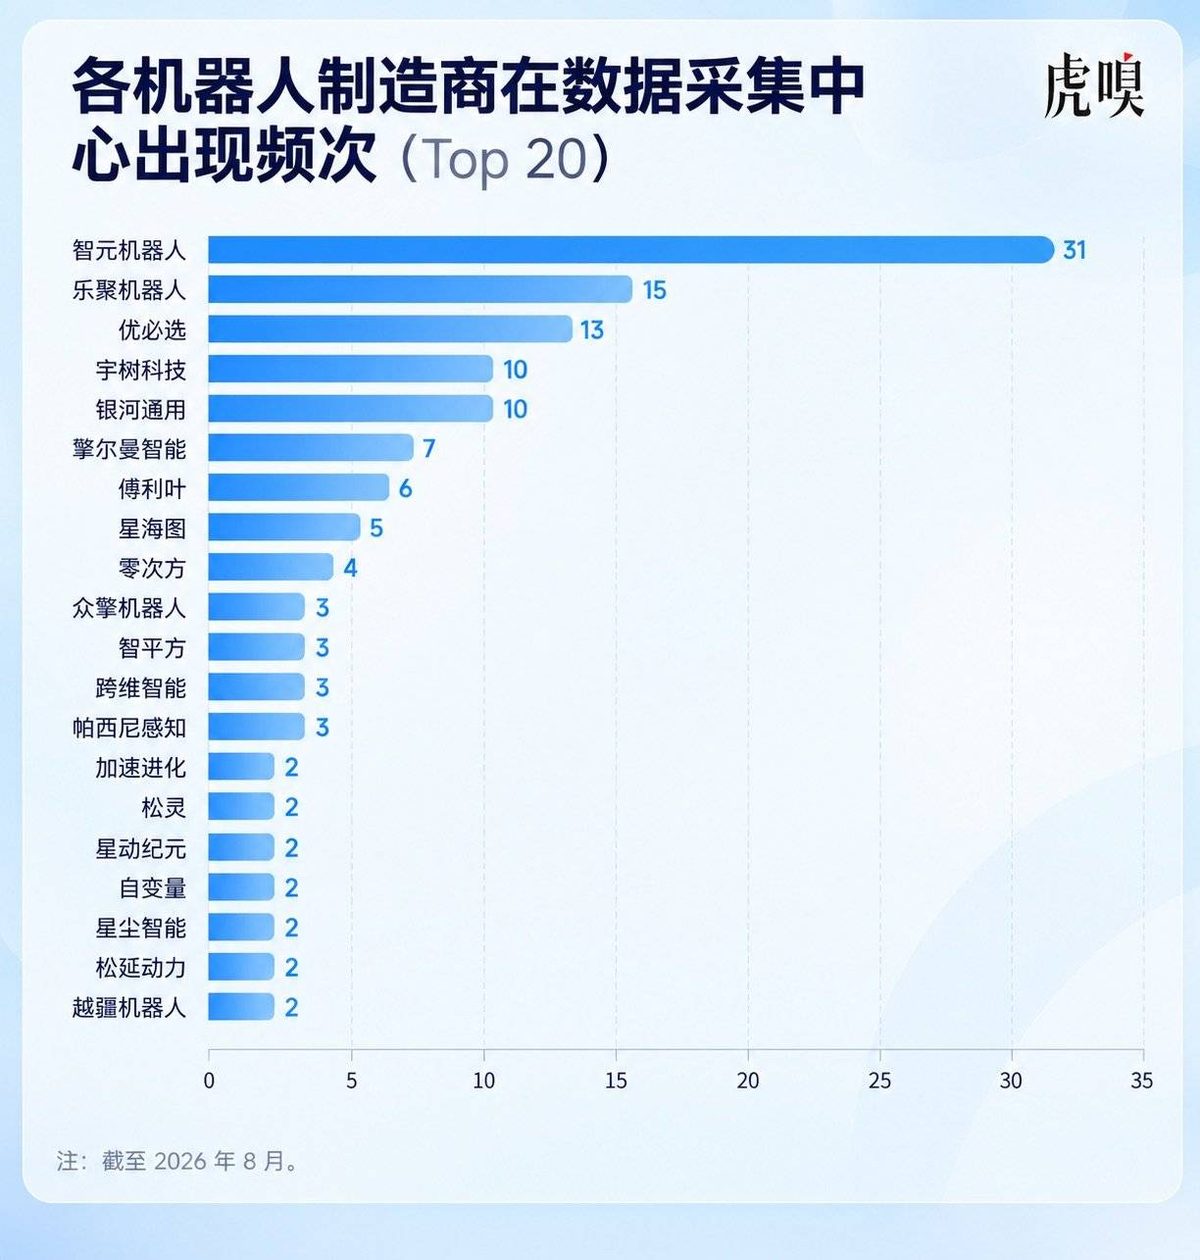
虎嗅注:上述数据以公开披露信息为准
不过,从品牌结构来看,目前多数数采中心仍然围绕单一本体运行。
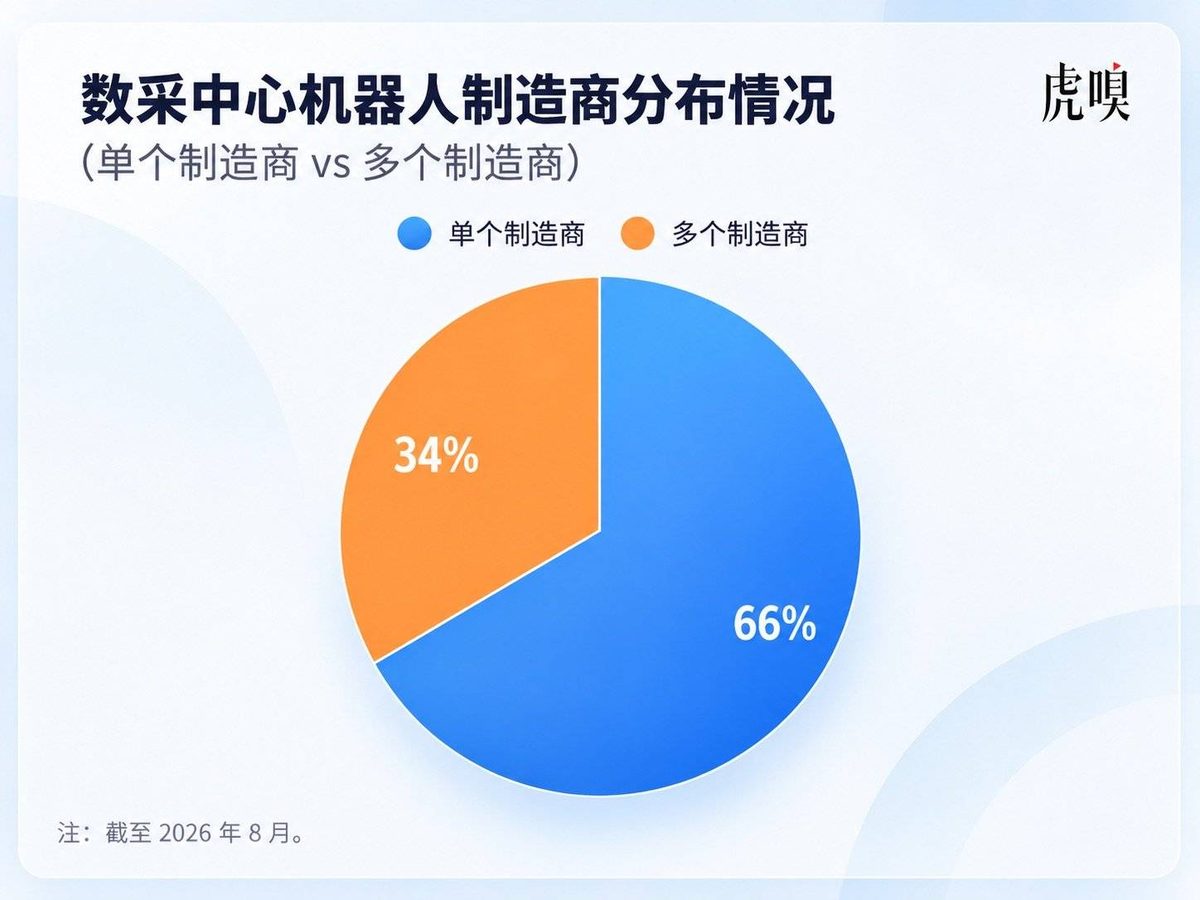
统计显示,65.96%的数采中心采用单一机器人品牌,说明当前多数数采中心倾向于与特定机器人制造商深度合作。
这和现阶段数采中心的建设方式有关。
企业自建基地通常围绕自己的机器人搭建,部分政企共建项目也会绑定一家主要合作方。机器人型号确定后,遥操系统、数据格式和采集流程也会随之固定下来。
这样的模式效率更高,但数据复用却成了新的问题。
不同机器人的自由度、关节结构、传感器和控制方式并不一样。同一个“开抽屉”或者“抓取零件”的任务,换一套本体后,原来的数据往往需要重新适配,有些甚至要重新采一遍。
一位具身数据服务商告诉虎嗅:“现在各家都在采自己的数据,最大的问题是很难跨本体复用。同一个任务,A公司采过一遍,换到B公司的机器人上,很多时候还得重新来。”
因此,一些规模较大的训练场已经开始引入多品牌机器人,尝试做异构、跨本体采集。
目前,34.04%的数采中心采用多品牌策略,其中2-4个品牌的组合最为常见,部分甚至运行了6-7品牌。这有助于采集更丰富、更多样化的机器人数据,提升模型的泛化能力。
然而,把不同品牌的机器人放进同一个训练场,只是第一步。
不同本体之间还需要解决动作映射、数据对齐、接口标准等问题。一套数据究竟能在多大程度上迁移到另一台机器人上,迁移之后又能给模型带来多少提升,目前仍缺少统一答案。
这也是集中式数采中心增速放缓的重要原因之一。随着数据规模不断扩大,行业关注的重点正在从“数量”转向“质量”。
真正稀缺的,是能够跨本体复用、可以直接进入训练流程的高质量数据。而这类数据,很难靠单纯增加机器人数量和采集时长堆出来。
84家已经投用,接下来谁来买单?
真正难的问题,出现在数据采出来以后。
虎嗅询问了多家数采基地运营方,得到的回答基本一致:目前集中式数采还没有形成稳定的商业闭环。
现阶段,数采中心生产的数据大致有三个去向。
第一种是企业自用。对于本体企业自建的数采基地,这也是最直接的一种方式。机器人在基地里采到的数据,经过清洗和处理后,进入自己的模型训练和产品迭代。
第二种是对外合作。数采中心按照客户需求采集数据,再卖给机器人公司、模型公司或数据企业。
第三种则是开源。部分企业会选择公开部分数据集,用来吸引开发者、完善生态。
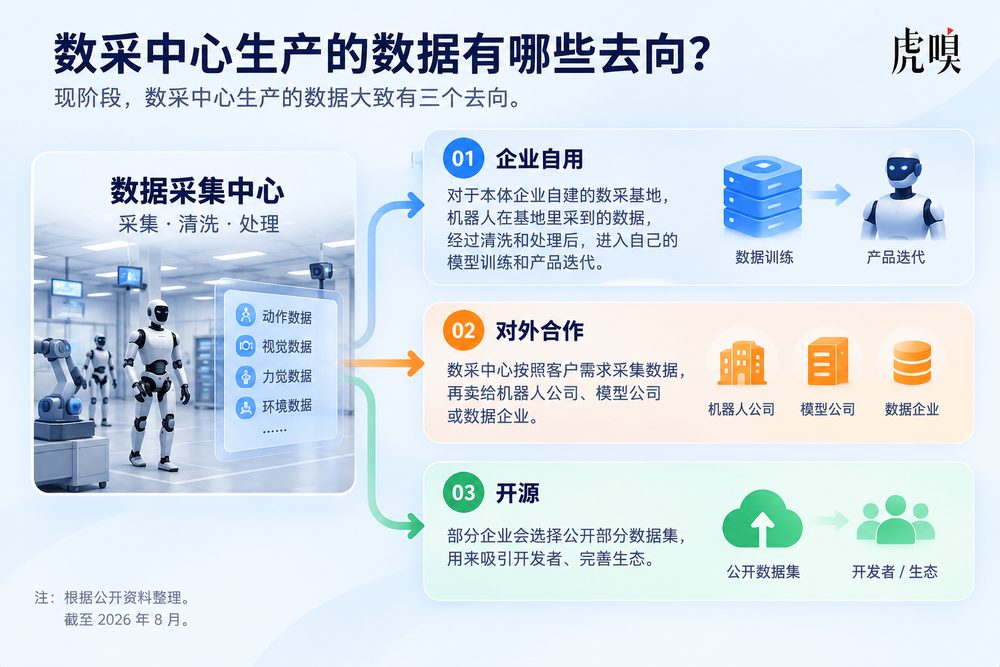
三种模式里,真正决定第三方数采中心能否持续运营的,还是第二种。
问题在于,买家并没有随着数采中心一起快速增加。
头部本体公司大多在建设自己的数采体系,大模型公司对于数据格式、质量和任务场景也有自己的要求。至于中小企业,虽然缺数据,但很难长期承担大规模真机数据的采购成本。
一位数采基地运营负责人告诉虎嗅,真正愿意持续购买数据的客户比较少。“很多公司会先买一批试试,后面能不能形成长期订单,还得看模型训练效果。”
据调查,当前真机数据约500至1000元/小时,无本体的UMI等数据约300至400元/小时,仿真合成数据则在200至500元/小时。
但数据本身也越来越难按“小时”简单定价。同样采100个小时,遥操员水平、任务成功率、场景复杂度、机器人状态不同,最后能进入模型训练的数据量可能相差很大。
买方开始更关心数据能不能直接用于训练、能带来多少模型效果提升,而数采中心过去习惯强调的“机器人数量”“采集小时数”,重要性正在下降。
数采中心的成本却相对固定:机器人折旧和维修、遥操人员、场地、场景搭建、数据清洗、标注和质检,每一项都需要持续投入。
建设阶段可以依赖项目资金,到了运营阶段,收入来源就成了绕不开的问题。一座基地有100台机器人,并不意味着100台机器人的产能每天都能被消化。
与此同时,数采方式本身也在变化。
统计的106家中心中,遥操仍然占据绝对主流,共出现83次,占79.05%。仿真、Ego、动捕等路线也在被越来越多地采用。
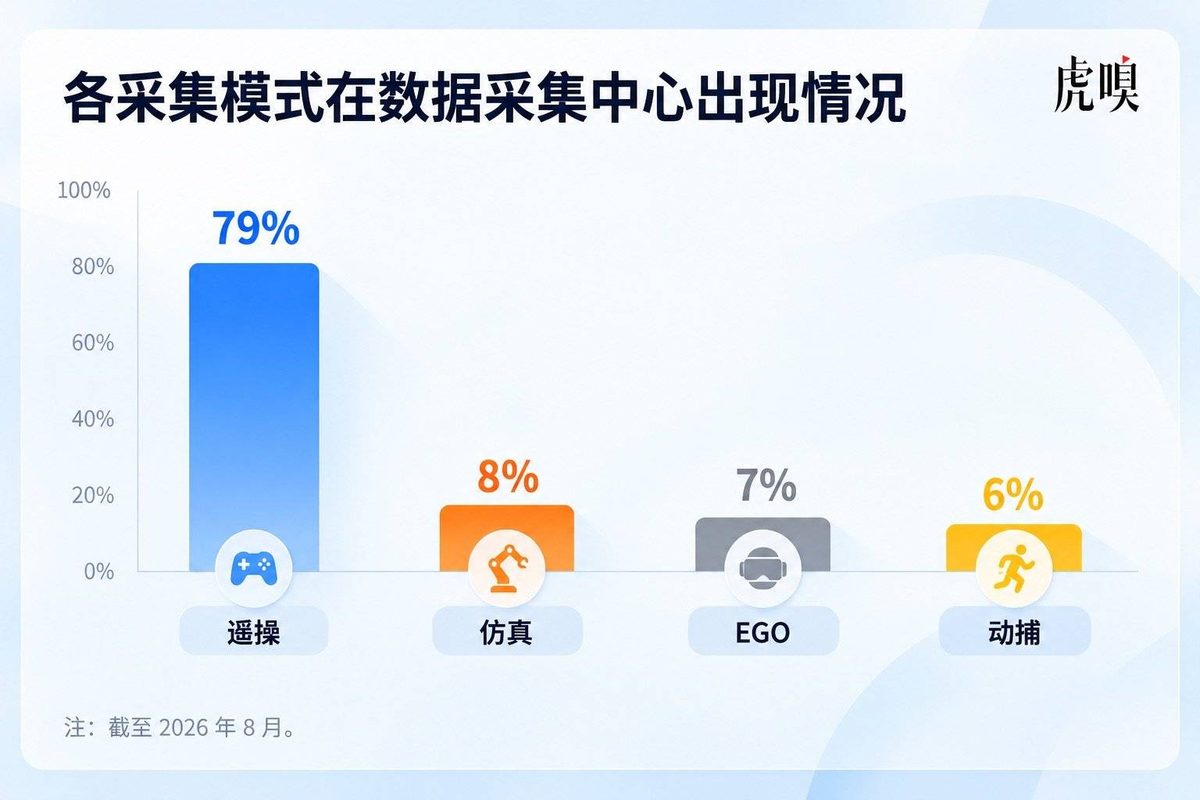
遥操能够获得相对完整的真机数据,但人工成本高、采集速度慢,还伴随着机器人损耗。过去两年,Ego、UMI、动作捕捉、仿真和合成数据陆续进入训练流程,一些企业也开始尝试用世界模型生成训练样本。
技术路线还在快速变化,已经建成的数采中心却是一笔相对重的投入。几十台机器人、遥操设备、场景和人员体系一旦配置完成,调整起来并不轻松。今天投入使用的设备和采集方式,几年后是否仍然经济,需要重新计算。
从全国106家中心的变化来看,集中式数采已经走过了“先把基地建起来”的阶段。
接下来,行业大概率会进入一轮分化。
本体企业自建的基地,有内部模型训练需求托底;拥有稳定客户的第三方中心,可以继续围绕数据服务寻找收入;能够处理异构本体、提高数据复用率的公共训练场,也仍有存在价值。
而那些主要依赖一次性建设资金、缺少持续数据需求和客户订单的中心,运营压力会越来越大。
数采中心的建设潮已经结束,淘汰赛才刚刚开始。