文|Tech星球 华卫
今早,小米和SpaceXAI分别发布了各自的新模型。小米 MiMo 团队负责人罗福莉在X平台(原Tiwter)上宣布MiMo-V2.6系列正式开源,马斯克则推出了预告近两个月的Grok 4.7。
更戏剧性的是,分属开源和闭源不同阵营的两个模型,拿到了相同的智能指数跑分,成本却差了数十倍。有网友调侃道,“真不知道该说马斯克完蛋了,还是该说 MiMo 的粉丝们可以扬帆起航了。”
成本差距是怎么拉开的?
这次小米的新模型依然是两个版本,MiMo-V2.6 系列包括 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 两款原生全模态模型,其中 Pro 是目前 MiMo 能力最强的模型,Flash 更强调能力、效率与成本之间的平衡。MiMo Desktop 还同步上线 MiMo-V2.6-Pro 的 UltraSpeed 超高速模式,提供最高 20 倍的输出速度,满足强实时交互与对响应速度敏感的场景。
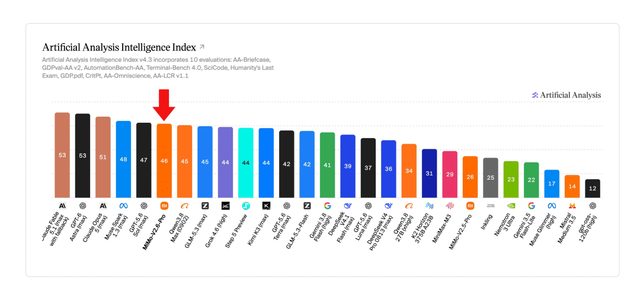
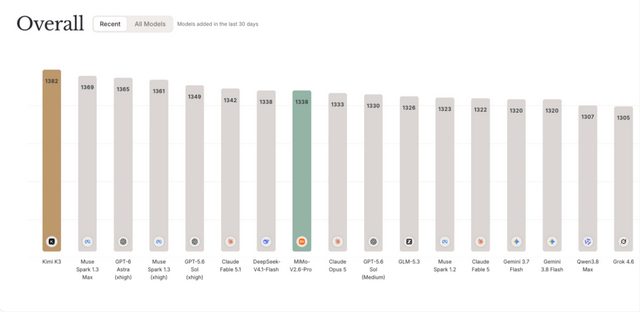
在 Artificial Analysis Intelligence Index(AA综合智能指数)中,MiMo-V2.6-Pro 取得 46 分,虽与闭源模型 Claude Fable 5.1 和 GPT-6 Astra 相比仍有差距,但超过 Kimi K3 和 Qwen3.8 Max,成为当前最强的开源模型。
另一边,Grok 4.7的跑分成绩也处在同一水平。并且,Grok 4.7 刚拿到同样的46分时,还被 Artificial Analysis评价“SpaceXAI 已跻身前四大人工智能实验室之列”。
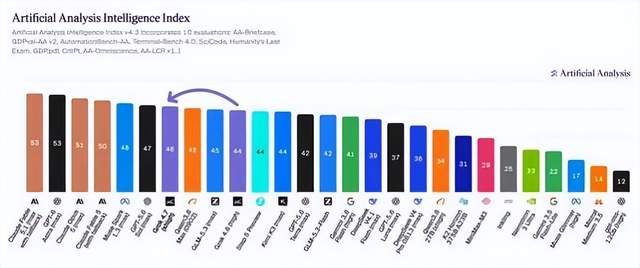
马斯克还在X上发帖表示,Grok 4.7 是一款集智能、速度和低成本于一体的强大产品。SpaceXAI 官方更直接宣称,它的速度可达到同类模型的两倍,价格只有一半。
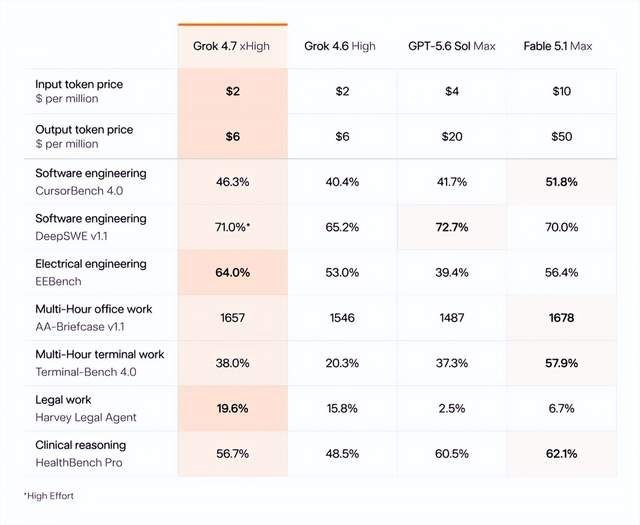
然而,“打脸”来得太快。首先是 API 价格上,Grok 4.7和MiMo-V2.6两款模型都沿用上一代模型的定价,前者与 Grok 4.6 相同,后者和 V2.5 系列一致。但同样的智能水平,MiMo-V2.6要便宜得多。
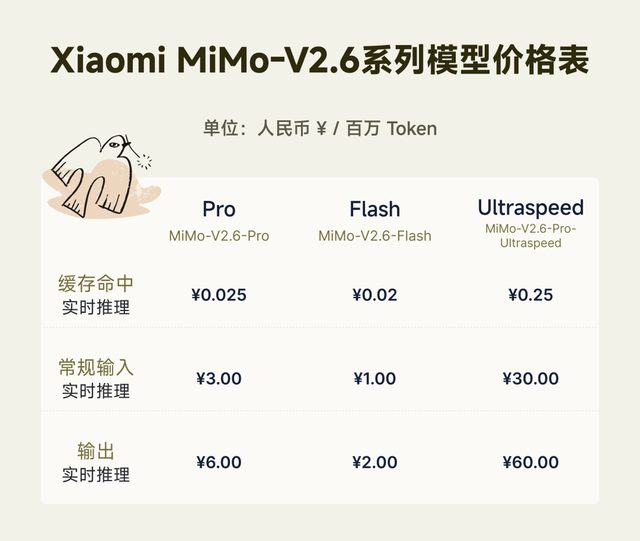
其次,Grok 4.7的贵不仅是单价问题。Artificial Analysis数据显示,MiMo-V2.6-Pro每项Intelligence Index任务成本0.13美元,整个评估运行成本206.66美元;Grok 4.7(xhigh)每项Intelligence Index任务成本3.74美元,整个评估花费4967.35美元。
在任务成本上,MiMo-V2.6-Pro比Grok 4.7(xhigh)相差近29倍,而Grok 4.7的高成本,可能很大程度来自“话多”和“慢”。在评估智能指数时,它生成了 2.4 亿个Token(词元),与 9400 万的中位数相比,这个数字属于“非常冗长”的水平。并且,Grok 4.7 (xhigh) 每秒仅能处理 39 个词元,速度明显较慢 。对于较长的提示,Grok 4.7 的答案输出速度约为每秒 188 个词元。
对此,网友们直接贴脸开大:“小米用一个开放权重模型追平了 Grok 4.7 的价格,马斯克这次发布现在简直是个笑话。”还有开发者表示,“既然我们已经拥有了Fable级别且价格更低的全新国产SOTA模型,那么使用 Grok 就显得毫无意义了。”
同台竞技,Grok,4.7又输惨了?
同一时间窗口发布的两家模型,被不少开发者放到了同一个竞技场上。但仔细看,两者的能力拓展方向其实有所不同。
SpaceXAI 给 Grok 4.7 的定位很明确:专为编程和知识工作而生。据官方介绍,与前代模型相比,Grok 4.7 使用了更大更新的基础模型。它经过更长时间的强化学习训练,任务组合也更加复杂,尤其侧重于那些需要花费数小时才能完成的问题。
因此,该模型在验证自身工作和处理更长的上下文方面表现更佳,能更长时间地处理复杂任务,更仔细地检查自身运行结果,并配备了完善的安全保障措施。此外,Grok 4.7 能够原生理解Grok Bot框架,从而提升了其在对话任务和通用知识处理方面的能力。
这在其公开的基准测试数据上也有所体现。在长流程知识工作测试 AA-Briefcase v1.1 中,Grok 4.7 拿到 1657 Elo,比 Grok 4.6 的 High 档高出 111 分。在GDPval-AA 上,它拿到 1695 Elo,比前一代高出 90 分,该测试专注于评估大模型在模拟真实工作场景中的“实用性”和“经济价值”。
另一个值得注意的变化是,Grok 4.7的上下文窗口从上一代的 256K 扩展到了 500K,但仍然没到当下国产模型几乎标配、小米 MiMo-V2.6 同样达到的 1M 门槛。
编程方面,在考察长时间编码任务 CursorBench 4.0 上,Grok 4.7 取得 46.3%,高于 Grok 4.6 的 40.4%。在评估模型终端操作能力的 TerminalBench 4.0 里,Grok 4.7从 20.3% 提升至 38.0%,但跟DeepSeek V4.1 Flash是平齐的,连GLM 5.3 Flash都没比过,更别提前面的GPT-6、Fable 5.1。
相比之下,小米给 MiMo-V2.6 设定的能力边界要宽得多,官方演示案例涵盖了多智能体游戏开发、Blender 3D 建模、基于多视角相机输入对 Franka Panda 机械臂的闭环控制、前端与演示设计、端到端视频创作以及音乐作曲等。
据介绍,MiMo-V2.6 融合了 3D 空间推理、多模态感知与计算机操作(CUA)能力,将自然语言驱动的编程任务升级为面向交互世界构建的“Vibe World”。同时,该模型进一步拓展了 Computer Use 能力,将多模态感知与原生训练的行动能力相结合,可以理解复杂的图形界面,使用常见办公与生产力工具完成信息检索、编辑和数据处理等任务,并根据视觉反馈检查结果、排查问题、调整后续行动。
根据小米公布的测试结果,在考验终端真实交互的 Terminal Bench 2.1 上,两款模型分别为 89.9 分和 87.6 分。通用智能体测试中,Pro 在 AutomationBench v1.0.6 上获得 53.1 分,高于Claude Opus 5、GPT-5.6 Sol 和 Claude Fable 5;Flash 为 52.3 分。在 OSWorld-Verified 上,两款模型分别取得 82 分和 80.8 分。在设计评测榜单 Design Arena 上,MiMo-V2.6-Pro 取得了与 Claude Opus 5、 GPT-5.6 Sol 相近的水平。
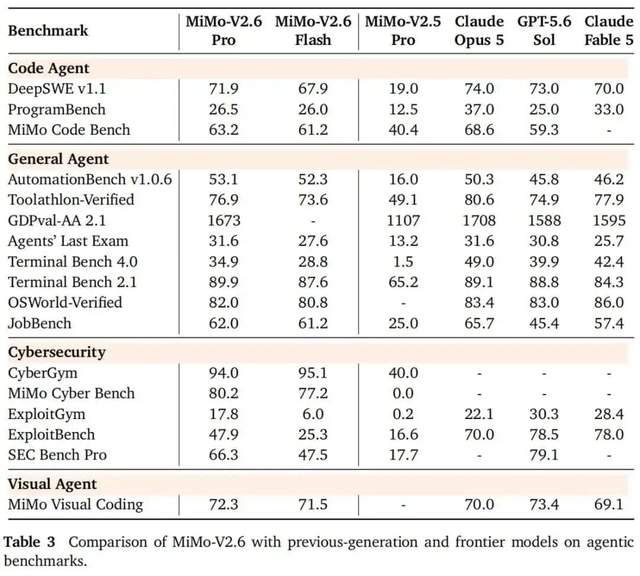
但把两款模型放到同一张考卷上,情况就变得微妙了。在专门考察长程软件工程能力的 DeepSWE v1.1 中,Grok 4.7 得分为 71,略低于 MiMo-V2.6-Pro 。MiMo-V2.6-Pro 在 DeepSWE v1.1 软件工程长程测试上取得 71.9 分,明显高于上一代 MiMo-V2.5-Pro 的 19 分;Flash 为 67.9 分。
此外,有不少开发者对两款模型进行了测评对比,结果更具冲击力。Grok 4.7不仅成了许多案例里的反面教材,还被评价“存在就是为了更好地衬托MiMo-V2.6 Pro的惊艳光芒”。
一位开发者向两款模型给出同一个Three.js单文件提示,结果MiMo-V2.6交付了完整的发射场,Grok 4.7磨蹭半天才吐出一个扭曲的麻花,没有发射塔、储罐、地面,只有一团烟雾和一个扭曲的雕塑。
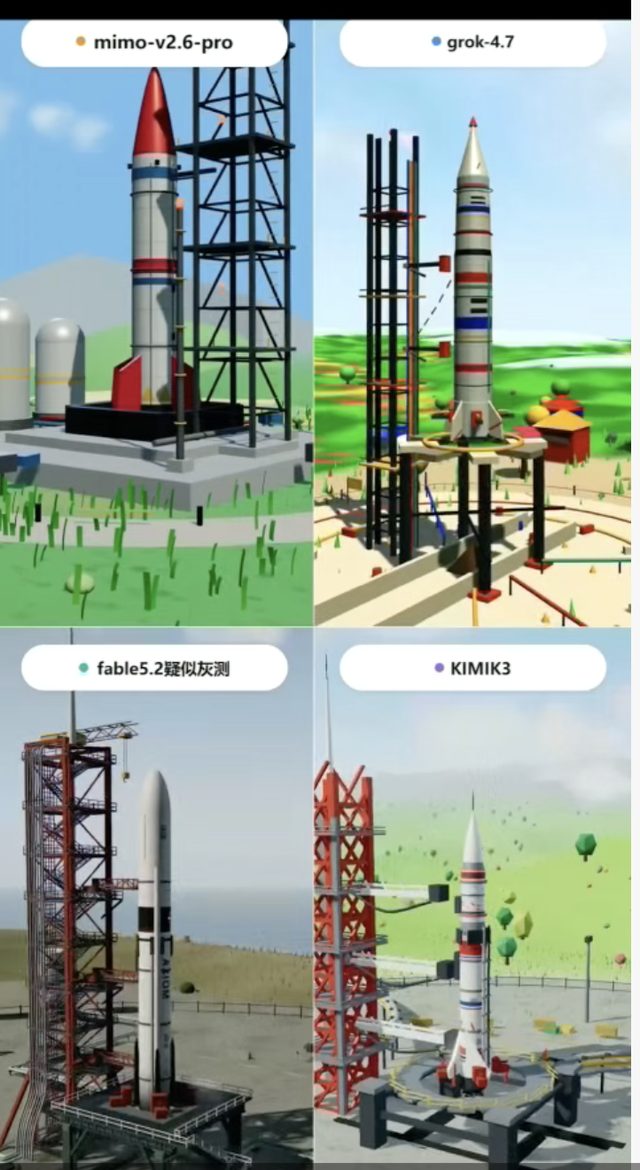
还有开发者让它们各自生成一幅3D渲染的墨水画,MiMo-V2.6拿出的成果也更为生动。
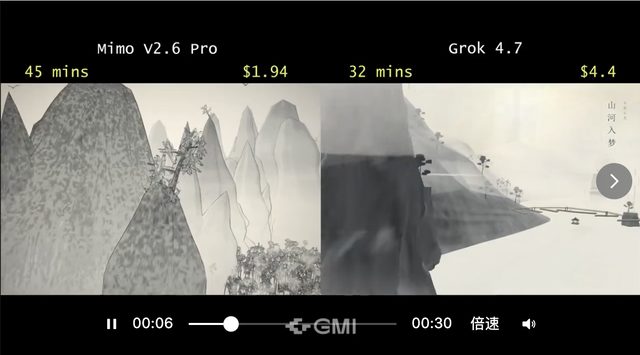
可以看到,Grok 4.7在自己的Benchmark里已经完成了明显升级,在长流程知识工作、终端操作和软件工程任务上都拿出了不错的成绩。但在实际生成任务中,MiMo-V2.6虽然价格更便宜,但展现出了更强的“交付感”。
让马斯克“吃亏”的秘密,小米都公开了
“在我看来,这轮训练涉及的研究创新和工程挑战已经超过 DeepSeek R1。”小米 MiMo 团队负责人罗福莉以曾参与 R1 部分工作的视角表示。
据悉,MiMo-V2.6在中等难度的可验证任务上运行MixRL,包括代码及相关智能体任务,所得模型泛化得非常好。其次,难以验证、极长程,或困难到无法纳入联合RL训练的任务,会单独训练。把它们纳入会大幅降低rollout效率,或引入严重的rollout陈旧性。然后我们通过MOPD合并所得能力,游戏、3D任务以及带主观评估信号的任务,都属于这一类。
罗福莉透露,按算力衡量,MiMo-V2.6 很可能是开源模型团队迄今规模最大的单次强化学习(RL)训练之一。她表示,“在算力极度稀缺的时代,我们仍然选择让一支数十人的团队在很长一段时间里专注于一个目标:扩大RL规模。这需要的不仅是研究信念,还需要对AGI的愿景、对未知的敬畏,以及直面最难问题的勇气。”
这轮训练过程,小米在模型发布之前就进行了公开直播,全系列的训练 Step、Token 消耗、任务通过率、评测成绩、基础设施故障和累计费用都可以实时查看,这在国产大模型发布中极为罕见。
不到六天的时间里,MiMo-V2.6-Flash 和 MiMo-V2.6-Pro 分别完成了 30 个 RL 步骤,总计约 75 万条轨迹,成本分别约为 85 万美元和 262 万美元。汇总显示,两轮 RL 累计训练 150.5 万个样本、1564 亿 Token,总成本约 347 万美元。
此外,在这次模型发布中,小米首次明确地提到了 RSI 路线,将 MiMo-V2.6 看作“探索 RSI(递归自我改进)路径的关键一步”。“MiMo-V2.6仅仅是一个开始。在一个智能易于复制的时代,我们仍选择通往自我改进和AGI的艰难道路”,罗福莉表示。
值得关注的是,当国产开源模型以同级海外模型数十分之一的成本,交出足以比肩前沿的能力时,行业竞争的紧迫感随之而来。
在大洋彼岸,马斯克已经开始为下一轮出牌蓄势。按照他公开透露的信息,Grok 4.8将在本周完成预训练,并开始进入强化学习阶段,其参数规模约为 2.5 万亿,并采用一套全新的 C++ 软件栈训练。
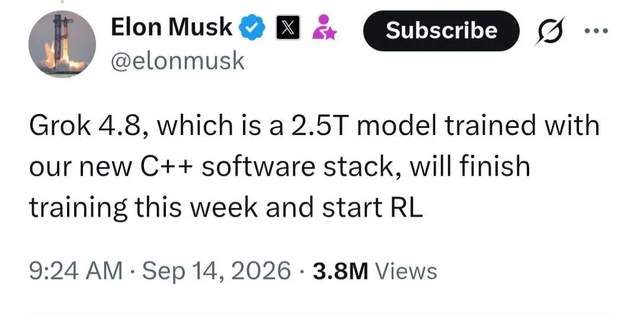
罗福莉选择一步步推进RSI之路,马斯克则把筹码压在全新的训练栈上,赌一次更大幅度的跃升。下一次对决,马斯克能否扳回一局,且拭目以待。