Jay发自 凹非寺
量子位 | 公众号QbitAI
0.2秒。
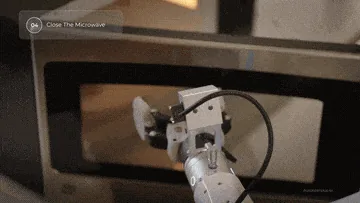
这是一台机器人正在关闭微波炉门时,因人手突然插进来而紧急悬停的时间。
还有更有趣的。
当一只金属易拉罐被混在蛋糕盘里端向微波炉,机械臂会先把易拉罐挑出来放到一旁,确认盘子里安全了,再将其送入炉内。
说实话,看这几段Demo的时候,我整个人是有点愣住的。
长期关注具身的朋友应该都有体会,现在很多机器人看起来挺炫酷,但大部分时候都是在「背题」。一旦光照变了、东西被踢了一脚、或者指令稍微带点隐含意图,机器人瞬间就抓瞎了。
但你即便像视频里这样,疯狂拿手电筒闪这个机器人的眼睛,它依然置若罔闻。。。
不过,刚才那些画面,不是提前录好的动作回放,也不是碰巧猜对的统计相关性。
面对接连不断的突发扰动,系统是基于对物理世界因果规律的理解,实时推理出了这一连串动作。
驱动这个机器人的这套系统,代号叫CRIS-0。
它的背后,正是由加州大学圣地亚哥分校(UCSD)助理教授、CMU因果学派学者黄碧薇创立的因果智能企业——
Aether AI。
三个月前,量子位曾报道过这家公司选择的因果智能路线。当时很多人以为因果AI还停留在数学公式和思维实验里。
如今,Aether AI亮出了官方Demo。
告别机械「抓瞎」:机器人学会看懂因果
在具身机器人的落地场景中,最让工程师头疼的向来不是标准流程,而是无处不在的意外。
传统机器人面对突发扰动,要么机械地重复旧坐标导致碰撞,要么干脆全流程报错卡死;而端到端黑盒模型在几十步的长程任务里,更是极易产生累积误差,一步走偏满盘皆崩。
CRIS-0给出的破局解法,是「因果」——
让机器人从「看到什么」,走向「理解为什么发生、改变什么会影响结果」。
先看成绩单。
在面对外部突发干扰的Coffee Preparation测试中,机器人抓取咖啡机时遭遇人为移位、光照突变。CRIS-0在平均2秒内就识别出了因果变量的改变并完成实时重规划,在10次随机扰动中实现了9次有效恢复。
而且并不是盲目地全流程重来。
咖啡机被推开,系统追踪的是「把手相对位姿」这一关键因果变量。当发现变量状态发生偏移,它只会修正接近和抓取的动作阶段,无需回归原位重启。
抗干扰只是基本功,到了长程自主任务中,因果驱动的优势体现得更为彻底。
在「客厅寻物与整理」这种多达数十步的连续任务中,系统把长程目标拆解为原子化、可验证的因果阶段,每推进一步都执行前置与后置条件检查。
更有意思的是CRIS-0展现出的常识推理与物理感知能力:
在清理桌面时,它会把散落的普通书本整理至茶几,却把涉及个人隐私的账单收纳进抽屉;
面对两个外观相似的饮料罐,它先通过抓取晃动来感知罐体重量与内部液体状态,确认为空罐后才扔进垃圾桶,感知到未喝完的饮料则稳稳放回原位。
最后,在面对模糊需求时,因果还能大幅提高提示词泛化性,从而带来个性化理解能力。
在Personal Pick and Place测试中,面对类似「给我拿一瓶适合晨跑后喝的饮料」等20条需要隐含推理的模糊指令,系统取得了18次精准抓取与放置的成绩。
它不是靠记忆关键词去碰运气,而是结合时间、用户状态与环境上下文,把「运动后需要补充能量且避免高糖」作为隐藏因果变量抽取出来,自动匹配对应操作。
这些Demo背后,到底是一套怎样的技术架构?
拆解CRIS-0:把黑盒改造成因果引擎
回答这个问题前,或许我们得先讲清楚另外一个问题——
为什么以前的机器人总是让人觉得「笨」?
物理世界和纯数字世界完全是两码事。在电脑里写代码或者聊天,输错了还能撤回,但在现实世界里,摩擦力、重力、碰撞、光线变化,各种突发情况每秒钟都在发生。
传统的端到端模型,比如VLA方案,虽然学得很快,但在面对长流程任务时,有一个致命弱点,那就是误差累积。
第1步有点小偏差,第2步偏差变大,到了第10步,整个动作可能就已经彻底变形了。更要命的是,单一黑盒模型在遇到干扰时,它不知道到底发生了什么,往往只能硬着头皮继续往下按原计划推,或者直接崩溃停机。
而另一种常见的Agent方案,虽然会做步骤拆解,但它的思考逻辑基本停留在纯文本或者多模态大模型的概率推理上。
每次环境一变,它得先把画面转成文本,等模型在那慢吞吞琢磨「下一步该干嘛」,等你推理完了,手可能早就被门夹到了。。。
CRIS-0展现出来的这种抗干扰和连贯性,背后到底是怎么做到的?
Aether AI设计了一套全新逻辑:
因果原生的Agent架构。
可以从三个维度理解——
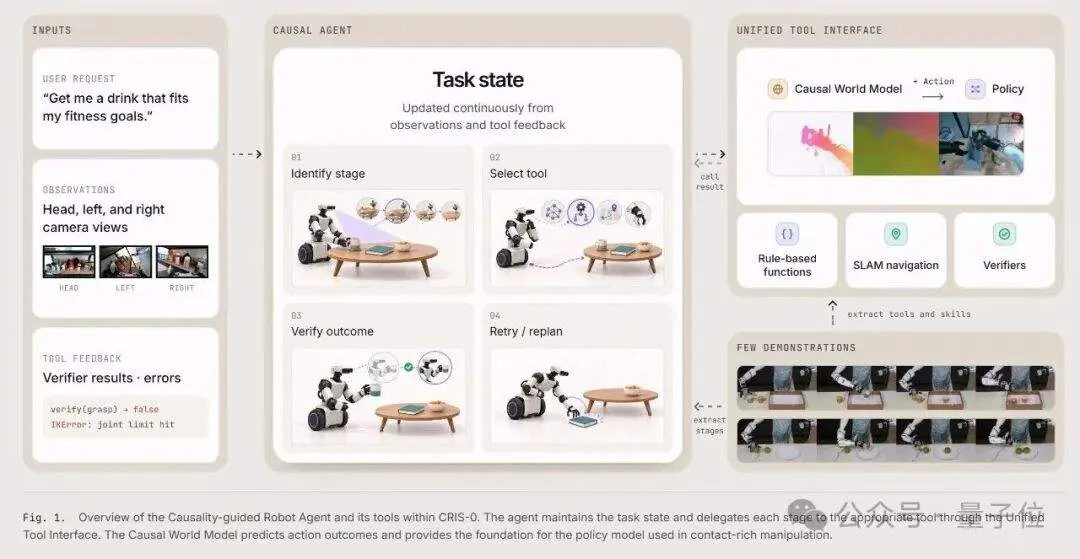
1. 任务即状态:提取物理因果变量
这是我觉得最重要的第一性原理。
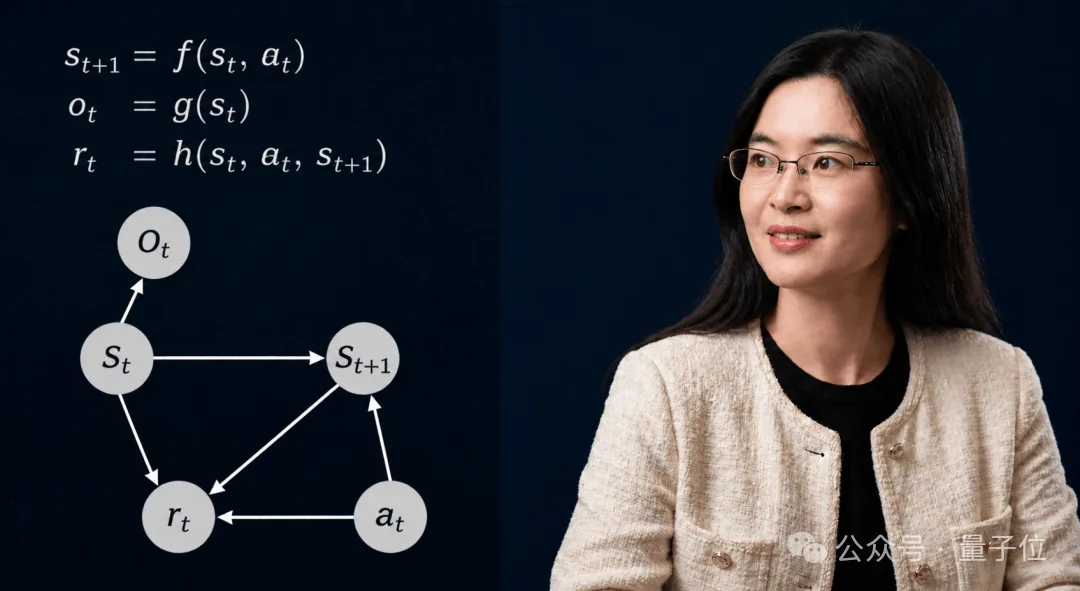
在CRIS-0的系统里,有一个非常底层的改变,叫做统一状态与因果变量。
以前的机器人看世界,看的是密密麻麻的图像像素。但在CRIS-0眼里,它关心的不是世界表面长什么样,而是任务到底进行到了哪一步,任务本身就是一个因果状态进度条。
举个特别接地气的例子,比如机器人去铺桌布。
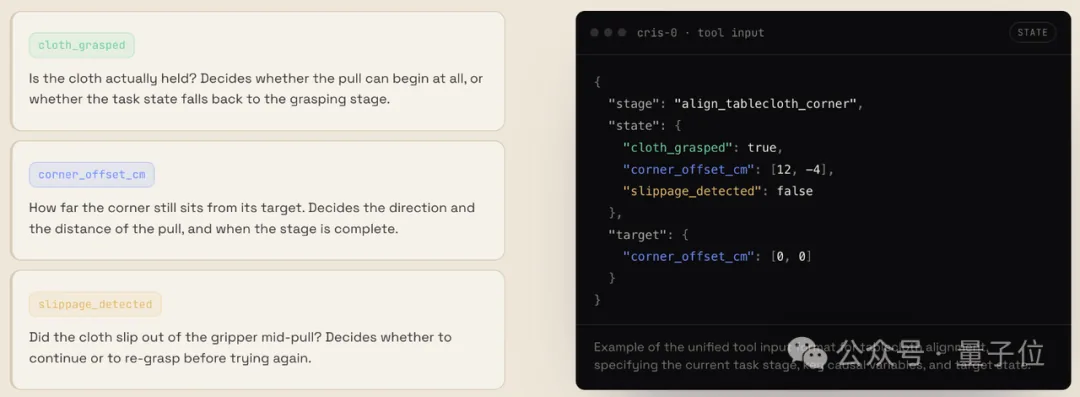
它不会傻乎乎地去计算整张桌布每个像素的坐标,而是实时追踪几个核心因果变量。比如桌布有没有被夹爪真正抓住,桌布的角点离目标位置还有几厘米,拉动的时候有没有发生滑移。
一旦抓取滑脱了,系统立刻知道是「抓住」这个因果变量不满足了,那么任务状态就直接退回到重新抓取的阶段,而不是把整套动作推翻重来,或者盲目地继续往后拉空气。
在官方公布的咖啡制作干扰测试里,面对咖啡机反复移位、光照突变这种折磨人的场景,系统平均在2秒内就能识别出关键变量的变化并完成重规划,10次外部扰动里做到了9次有效恢复。
这就是因果变量的威力,出了意外,它清楚地知道错在哪一步、该回退到哪一步。
2. 统一工具接口:拒绝单一策略包揽一切
那这个系统具体是怎样执行Action的?
答案是:Tool Call,不同工具各司其职。
在它的架构里,有一个负责总体调度的Planner,手底下管着一个功能齐全的工具箱,通过Unified Tool Interface将多种模块整合。
规则运动函数(Rule-based functions):结合视觉定位与逆运动学,高效解决大范围空间位移与预定位;
技能策略模型(Policy models):专门攻克倒水、精细抓取等高难度接触式操作(Contact-rich);
导航模块(SLAM):负责全局路径指引;
验证器(Verifiers):在每个阶段节点执行物理检查;
因果世界模型(CausalWM):负责推演动作带来的物理后果。
其中,最核心的杀手锏,正是这个因果世界模型。
很多朋友聊到世界模型,第一反应就是生成未来几秒的逼真视频。但CRIS-0里的CausalWM,更关注Action对环境的影响。
它的逻辑是,先看当前状态,再预测候选动作会导致哪些因果变量发生改变,最后推导出未来的状态。
换句话说,机器人在伸手之前,脑子里就已经在做推演了,例如:如果我这么做,把手会不会歪?杯子会不会倒?
相当于多了一个「排练」步骤,系统先在世界模型中推演「如果我执行动作B,物理因果变量会如何演化」,确认能达成目标后再调用Action Head,输出到底层控制。
3. 结构化循环与原生安全内建
而这一切的一切,都在Loop中循环往复。
面对复杂任务时,Planner会把大目标拆解开,先调用规则函数把夹爪快速移到目标附近,再调用策略模型完成精细的接触抓取。原本单一模型很难端到端搞定的复杂难题,就被拆成了几个确定性极高的小步骤。
具体而言,是这么一张动态演进的任务图(Task Graph):状态识别 → 工具选择 → 执行 → 验证 → 调整。
每做完一步,验证器都会立刻检查物理条件是否达成。如果没达成,系统有一套清晰的三级恢复机制,先判断能不能在这个阶段直接重试,不行就重新规划路径,再不行才提示需要人工介入。
一旦某次意外调整成功了,这条成功的恢复路径还会被记录沉淀到任务图里,下次再遇到类似情况,它会变得更熟练。
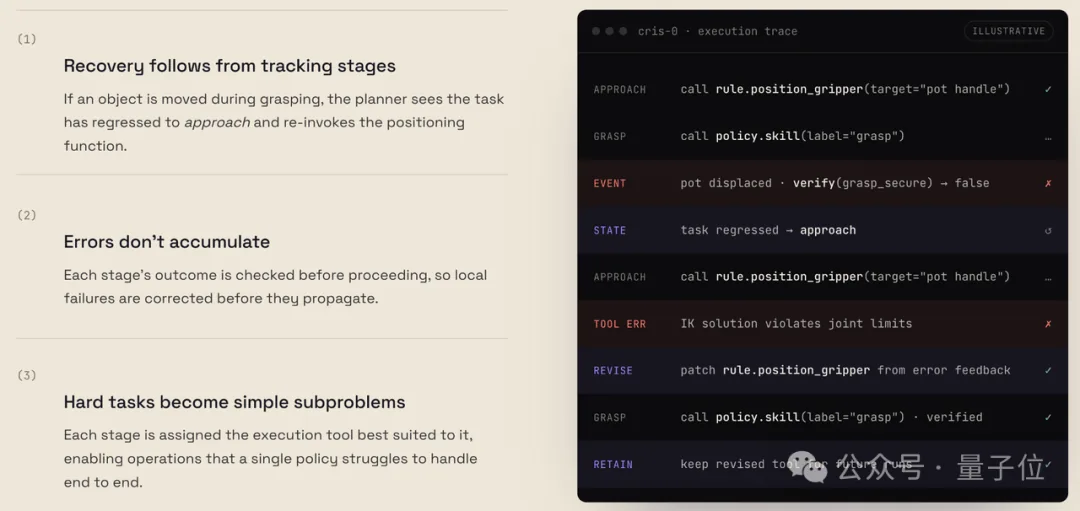
这也就解释了为什么在那个客厅长程整理的任务中,它可以连续执行几十甚至上百步而不崩溃。
因为它每走一步都在核对因果状态,错误在产生的第一时间就被就地解决了,根本没有机会像滚雪球一样扩散成全局崩溃。
同样,这也是为什么它能做到0.2秒的安全急停。
CRIS-0里面,安全判断是直接内嵌在每个因果阶段里的。
在关门这个阶段,突然出现的人手属于破坏用户安全条件的危险变量,系统在状态层就能瞬间捕获并触发最高优先级的阻断,0.2秒刹停。
但如果当前的任务是给人类递一杯水,那伸过来的人手就是交互的目标变量,系统就不会乱停。
事实上,CRIS-0展现出的这种系统级能力并非凭空而来,其背后有着扎实的研究基础支撑。
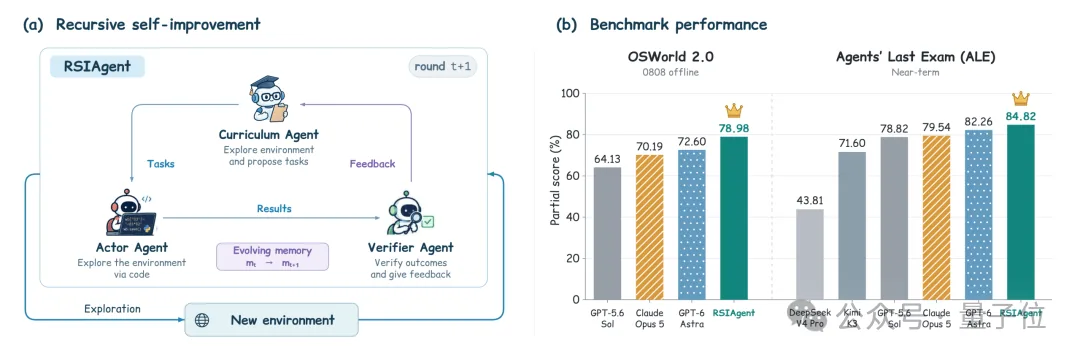
在Agent能力评估中,此前Aether AI的因果智能体框架RSIAgent在OSWorld 2.0上取得78.98% 的Partial Score,不更新模型参数,却能提升开源模型的Agent能力,超过了GPT-6 Astra等闭源模型。
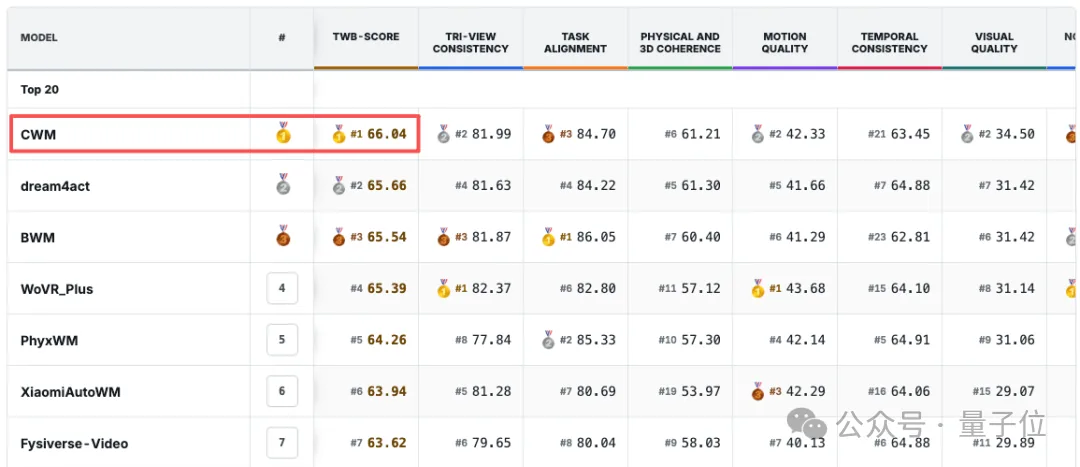
其第一版因果世界模型CausalWM也在机器人世界模型基准TriWorldBench上登顶Leaderboard,取得Top-1。
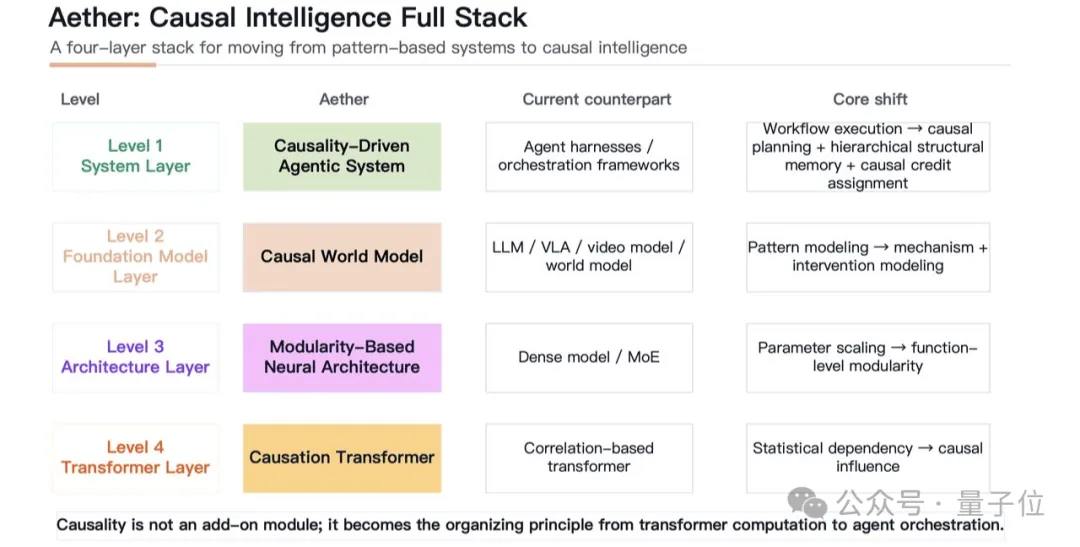
而这两层,正是本次Demo的主要贡献者。
另外,还有两层也在持续推进中——模块化神经架构:各模块对应不同因果机制,可组合可替换;Causation Transformer:学习因果关系而非统计依赖。
物理世界不相信死记硬背
聊到这里,我们其实可以跳出具体的机器人Demo,往更深的地方看一眼。
为什么现在大家越来越频繁地聊起因果智能?
坦率地讲,过去这一轮大语言模型的爆发,在很大程度上真是运气好,语言本身是一个被人类高度符号化、高度抽象的模态。很多逻辑和规律,本来就已经被人类总结在文本表面了。直接通过概率相关性的统计拟合大力出奇迹就行。
但物理世界不吃这一套。
摩擦力不会因为你看了十万篇论文就改变,重力也不会因为概率统计就突然消失。在充满复杂动态的真实世界里,单纯依靠表层相关性的拟合,迟早会撞上Scaling Law的天花板。
在物理数据严重不足的情况下,要做出真正能应对复杂物理环境的系统,模型必须学会像人类科学家一样,从少量数据中挖掘出底层的因果机制,理解行动究竟会如何改变世界。
这种以「因果」第一性原理结构化的压缩,或许才是具身原生的Scaling Law。
当然,这条路极其难走。因果发现和因果表征学习对数学与统计理论的要求极高,全球范围内真正兼具深厚理论积累和工程落地能力的团队少之又少。
Aether AI敢入局,很大程度上也和其独特的学术脉络有关吧。
黄碧薇在这个领域深耕了十几年,师承CMU因果学派奠基人Clark Glymour、Peter Spirtes以及第二代学者Bernhard Schölkopf和Kun Zhang,是因果发现学派的核心传承者之一。
三代因果学派的理论脉络,最终汇聚成了今天Aether AI的底层技术支柱。
从卡内基梅隆大学与马普所的理论积淀,到如今CRIS-0在真实机械臂上的具象呈现,因果智能终于踏出了走向物理世界的关键一步。
当一个系统真正具备了提取因果变量、建模世界动力学、并且在行动前推理后果的能力,它的用武之地绝不仅仅是帮人关个微波炉或者倒杯咖啡。
往更远的地方看,从复杂动态系统的趋势预测,到材料、生命科学等领域的科学发现,或许都能复用这套逻辑。
大时代啊,朋友们。
我们一直在期待AI能真正走出纯数字的聊天框,稳稳地立足于这个真实、复杂又充满未知的物理世界。
而因果,或许就是那把最重要的钥匙。
— 完 —
量子位 QbitAI · 头条号签约
关注我们,第一时间获知前沿科技动态